Dieser Beitrag ist die ausformulierte Fassung einer Präsentation, die auf dem "I Congreso Internacional de Geolingüística Románica", Salamanca, 14.-16. Oktober 2026, gehalten wurde.
 KI beteiligt / IA impliqué / IA coinvolta / AI involved
1. Geolinguistik – mehr als Dialektologie
Die Sprachverschiedenheit und die Variation der Einzelsprachen sind räumlich konditioniert; deshalb ist die Geolinguistik von besonderer Bedeutung für die Domumentation und Beschreibung der Sprachen, denn sie erfasst sprachliche Variation in räumlicher Perspektive. Alledrings kann sie sich nicht darauf beschränken, sprachlichliche Einheiten im geographischen Raum zu verorten, wie der ältere Ausdruck Sprachgeographie nahelegen könnte. Vielmehr besteht ihre viel umfassendere Aufgabe darin, sprachliche Varianten in einem mehrdimensionalen sozialen Raum zu identifizieren, der eine durchaus komplexe Modellierung erfordert. Zu unterscheiden sind drei Dimensionen, nämlich die Räumlichkeit der Sprache, des Sprechers und des Sprechens (bzw. Schreibens), die jeweils zu parametrisieren und zu spezifizieren sind; systematisch zu unterscheiden sind der Status der untersuchten Sprache/Varietät in der Gesellschaft, die Herkunft und Mobilität der Sprecher sowie die etwaige Medialität. Der Fokus der traditionellen Dialektologie lag (und liegt) auf dem lokalen Dialekt einheimischer Sprecher; andere Kategorien (etwa die Mobilität) fließen zwar de facto ein, etwa durch die Biographie der Informant:innen (vgl. Krefeld 2002a), jedoch ohne in ihrem variationellen Potential bewusst untersucht zu werden. Einen schematischen Überblick gibt die folgende Tabelle:
| Profilierung des kommunikativen Raums: Dimensionen und spezifizierte Parameter | ||
| Rote Umrahmung: Fokus der traditionellen Dialektologie | ||
| Dimensionen | Parameter | |
| Spezifikation | ||
| Sprache | Territorium | Staat/Nation: z.B. Deutsch in Deutschland |
| autonome Region: z.B. Deutsch in Südtirol | ||
| Areal | lokale Variation: z.B. Bairisch in Bayern/Österreich/Italien (BZ) | |
| Sprecher | Provenienz | autochthon (z.B. Bayer in Bayern) |
| allochthon, Migrant (z.B. Sizilianer in Bayern → Secondo → weitere Generationen) | ||
| Mobilität | Wohnort = Arbeitsplatz | |
| Wohnort ≠ Arbeitsplatz (Pendler) | ||
| mobile Lebenswelt (Transhumanz, Nomadismus1) | ||
| Sprechen | face to face | Sprechen ohne mediale Unterstützung |
| medial | Sprechen (Telephon, Spracherkennung), Schreiben (virtuell/analog) | |
Ein methodologisch komplexeres Verständnis der Variation wurde in der empririschen Arbeit, insbesondere in die Sprachatlanten erst durch die plurivariationelle Geolinguistik umgesetzt (vgl. ADDU, ALS, AsiCa2, ALiB 2014- u.a.). Seitdem dokumentieren die stets zunehmenden Daten nicht nur einen sehr weiten geographischen Raum, sondern eine ausgeprägte methdod(olog)ische Diversität, die eine umfassende Integration von Projekten bewältigen können muss.
2. Integration empirischer und methodischer Diversität
Von einander isolierte Datenbestände unterschiedlicher geolinguistischer Projekte.
In den letzten Jahren und Jahrzehnten sind zahlreiche geolinguistische Projekte und Datenbestände entstanden. Sie unterscheiden sich bezüglich ihrer Entstehungszeit, ihrer wissenschaftlichen Ausrichtung, ihrer geographischen Fokussierung, ihres Digitalisierungsgrades und der Datenstrukturen. Obwohl es zahlreiche inhaltliche Schnittmengen gibt, ergibt sich das Bild einer Vielzahl voneinander isolierter Einzeldatenbestände.
Die Aggregation und Integration zahlreicher Einzeldatenbestände in umfassender und strukturierter Form ist konzeptionell und technisch möglich. Entsprechendes hat z. B. das Projekt VerbaAlpina geleistet. Dort wurden gezielt Daten aus geolinguistischen Ressourcen wie Sprachatlanten und Wörterbüchern mit Informationen zur Georeferenz strukturiert erfasst und in einem gemeinsamen Datenbestand versammelt. Dadurch wurden die Dokumentationsräume der Einzelressourcen zu einem neuen übergreifenden Raum zusammengeschlossen. Die dadurch entstehende Veränderung der Perspektive bietet Impulse und eröffnet neue Möglichkeiten der Datenanalyse in einem erweiterten Untersuchungsraum. Die Abbildung illustriert die Abdeckung verschiedener Erhebungs- oder Dokumentationsnetze innerhalb des Untersuchungsraums von VerbaAlpina. Die Verknüpfung der bis dato von einander isolierten Datenbestände erlaubt u.a. die sprachfamilienübergreifende Analyse von Sprachdaten: Der Untersuchungsraum von VerbaAlpina deckt die romanisch-, germanisch- und slawischsprachigen Regionen des Alpenraums ab, inklusive mehrsprachiger Areale, wie z.B. das dreisprachige Kanaltal.
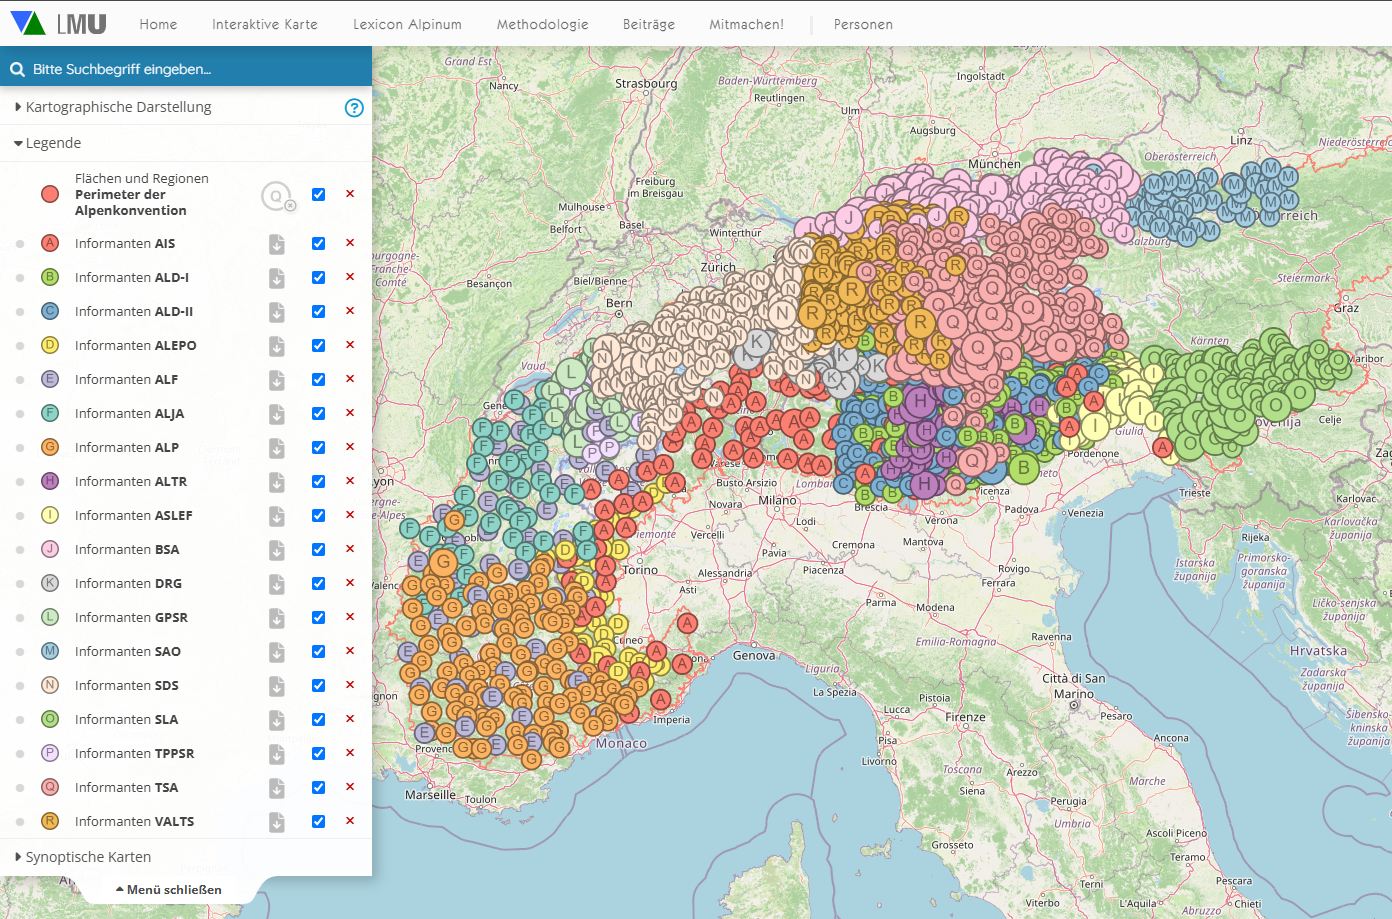
Integration mehrerer geolinguistischer Ressourcen in VerbaAlpina (https://www.verba-alpina.gwi.uni-muenchen.de?page_id=133&db=161&tk=5288)
Alle Belege fließen in einen strukturierten Datenbestand und können an der Nutzeroberfläche nach Lexemen, Konzepten und Orten gefiltert und heruntergeladen werden. Ein Beispiel liefert die VerbaAlpina-Karte BUTTER:
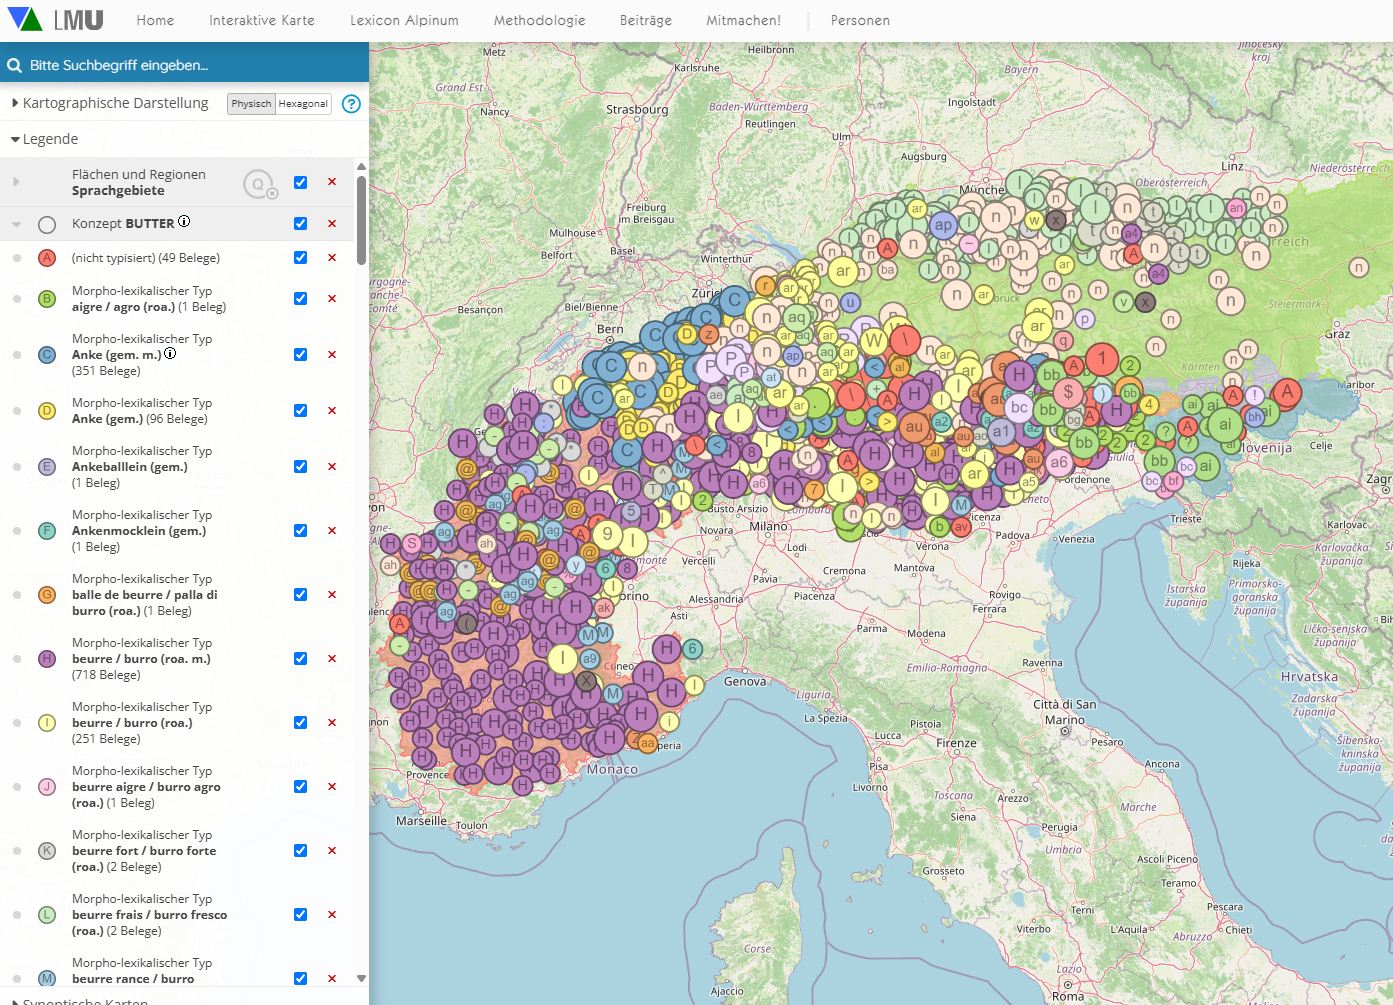
Integrierter ressourcenübergreifender Datenbestand: Kartierung unterschiedlicher Lexeme, die das Konzept BUTTER bezeichnen (https://www.verba-alpina.gwi.uni-muenchen.de?page_id=133&db=232&tk=5289)
Die von VerbaAlpina versammelten Daten sind keine direkten Kopien der erfassten Datenbestände. Das System besteht vielmehr in der Verknüpfung der Datenbestände, die in den meisten Fällen mit Abstraktions- und Ausgleichsprozessen verbunden ist. Letztlich handelt es sich bei den einzelnen Datensätzen um Zitate externer Ressourcen. Grundsätzlich ist für jeden einzelnen Datensatz die präzise Referenz der jeweiligen Datenquelle angegeben. In den Fällen, in denen die Ressourcen stabile, fein granulierte Internetadressen (URLs oder DOIs) anbieten, sind die Quelldaten bequem über einen Mausklick erreichbar. In anderen Fällen, z. B. bei herkömmlichen Buchpublikationen, werden die Verweise jeweils in Form traditioneller Zitatkonventionen angegeben. Im Rahmen der urheberrechtlichen Beschränkungen erfolgt die Verwaltung und Publikation der Daten von VerbaAlpina im Einklang mit den FAIR-Prinzipien (vgl. Krefeld/Lücke 2023a).
Der Nutzen einer projektübergreifenden Verknüpfung geolinguistischer Datenbestände liegt auf der Hand. Das, was VerbaAlpina im Bereich des Alpenraums gemacht hat, lässt sich natürlich auch auf einen noch größeren Maßstab transponieren. In romanistischer Perspektive wäre eine entsprechende Verknüpfung sämtlicher geeigneter Bestände romanischer Sprachen ein lohnendes Unterfangen. Ein entsprechendes System böte z. B. die faszinierende Perspektive, Daten aus der sogenannten Neuen Romania mit solchen aus der Alten zusammenzubringen. So wäre z. B. der Atlas Linguístico do Brasil (ALiB 2014-) ein wichtiger Baustein eines großräumigen Observatoriums. Die folgende Karte zeigt, welche Erweiterung des Ortsnetzes sich auf einen Schlag ergäbe:
Punto ALiB: 1 (Oiapoque)
Punto ALiB: 2 (Macapá)
Punto ALiB: 3 (Boa Vista)
Punto ALiB: 4 (São Gabriel da Cachoeira)
Punto ALiB: 5 (Tefé)
Punto ALiB: 6 (Manaus)
Punto ALiB: 7 (Benjamin Constant)
Punto ALiB: 8 (Humaitá)
Punto ALiB: 9 (Soure)
Punto ALiB: 10 (Óbidos)
Punto ALiB: 11 (Almeirim)
Punto ALiB: 12 (Belém)
Punto ALiB: 13 (Bragança)
Punto ALiB: 14 (Altamira)
Punto ALiB: 15 (Marabá)
Punto ALiB: 16 (Jacareacanga)
Punto ALiB: 17 (Conceição do Araguaia)
Punto ALiB: 18 (Itaituba)
Punto ALiB: 19 (Cruzeiro do Sul)
Punto ALiB: 20 (Rio Branco)
Punto ALiB: 21 (Porto Velho)
Punto ALiB: 22 (Guajará Mirim)
Punto ALiB: 23 (Pedro Afonso)
Punto ALiB: 24 (Natividade)
Punto ALiB: 25 (Turiaçu)
Punto ALiB: 26 (São Luís)
Punto ALiB: 27 (Brejo)
Punto ALiB: 28 (Bacabal)
Punto ALiB: 29 (Imperatriz)
Punto ALiB: 30 (Tuntum)
Punto ALiB: 31 (São João dos Patos)
Punto ALiB: 32 (Balsas)
Punto ALiB: 33 (Alto Parnaíba)
Punto ALiB: 34 (Teresina)
Punto ALiB: 35 (Piripiri)
Punto ALiB: 36 (Picos)
Punto ALiB: 37 (Canto do Buriti)
Punto ALiB: 38 (Corrente)
Punto ALiB: 39 (Camocim)
Punto ALiB: 40 (Sobral)
Punto ALiB: 41 (Fortaleza)
Punto ALiB: 42 (Ipu)
Punto ALiB: 43 (Canindé)
Punto ALiB: 44 (Crateús)
Punto ALiB: 45 (Quixeramobim)
Punto ALiB: 46 (Russas)
Punto ALiB: 47 (Limoeiro do Norte)
Punto ALiB: 48 (Tauá)
Punto ALiB: 49 (Iguatu)
Punto ALiB: 50 (Crato)
Punto ALiB: 51 (Mossoró)
Punto ALiB: 52 (Angicos)
Punto ALiB: 53 (Natal)
Punto ALiB: 54 (Pau dos Ferros)
Punto ALiB: 55 (Caicó)
Punto ALiB: 56 (Cuité)
Punto ALiB: 57 (Cajazeiras)
Punto ALiB: 58 (Itaporanga)
Punto ALiB: 59 (Patos)
Punto ALiB: 60 (Campina Grande)
Punto ALiB: 61 (João Pessoa)
Punto ALiB: 62 (Exu)
Punto ALiB: 63 (Salgueiro)
Punto ALiB: 64 (Limoeiro)
Punto ALiB: 65 (Olinda)
Punto ALiB: 66 (Afrânio)
Punto ALiB: 67 (Cabrobó)
Punto ALiB: 68 (Arcoverde)
Punto ALiB: 69 (Caruaru)
Punto ALiB: 70 (Recife)
Punto ALiB: 71 (Floresta)
Punto ALiB: 72 (Garanhuns)
Punto ALiB: 73 (Petrolina)
Punto ALiB: 74 (União dos Palmares)
Punto ALiB: 75 (Santana do Ipanema)
Punto ALiB: 76 (Arapiraca)
Punto ALiB: 77 (Maceió)
Punto ALiB: 78 (Propriá)
Punto ALiB: 79 (Aracaju)
Punto ALiB: 80 (Estância)
Punto ALiB: 81 (Juazeiro)
Punto ALiB: 82 (Jeremoabo)
Punto ALiB: 83 (Euclides da Cunha)
Punto ALiB: 84 (Barra)
Punto ALiB: 85 (Irecê)
Punto ALiB: 86 (Jacobina)
Punto ALiB: 87 (Barreiras)
Punto ALiB: 88 (Alagoinhas)
Punto ALiB: 89 (Seabra)
Punto ALiB: 90 (Itaberaba)
Punto ALiB: 91 (Santo Amaro)
Punto ALiB: 92 (Santana)
Punto ALiB: 93 (Salvador)
Punto ALiB: 94 (Valença)
Punto ALiB: 95 (Jequié)
Punto ALiB: 96 (Caetité)
Punto ALiB: 97 (Carinhanha)
Punto ALiB: 98 (Vitória da Conquista)
Punto ALiB: 99 (Ilhéus)
Punto ALiB: 100 (Itapetinga)
Punto ALiB: 101 (Santa Cruz Cabrália)
Punto ALiB: 102 (Caravelas)
Punto ALiB: 103 (Aripuanã)
Punto ALiB: 104 (São Félix do Araguaia)
Punto ALiB: 105 (Diamantino)
Punto ALiB: 106 (Poxoréu)
Punto ALiB: 107 (Vila Bela da Santíssima Trindade)
Punto ALiB: 108 (Cuiabá)
Punto ALiB: 109 (Barra do Garças)
Punto ALiB: 110 (Cáceres)
Punto ALiB: 111 (Alto Araguaia)
Punto ALiB: 112 (Coxim)
Punto ALiB: 113 (Corumbá)
Punto ALiB: 114 (Paranaíba)
Punto ALiB: 115 (Campo Grande)
Punto ALiB: 116 (Nioaque)
Punto ALiB: 117 (Ponta Porã)
Punto ALiB: 118 (Porangatu)
Punto ALiB: 119 (São Domingos)
Punto ALiB: 120 (Aruanã)
Punto ALiB: 121 (Formosa)
Punto ALiB: 122 (Goiás)
Punto ALiB: 123 (Goiânia)
Punto ALiB: 124 (Jataí)
Punto ALiB: 125 (Catalão)
Punto ALiB: 126 (Quirinópolis)
Punto ALiB: 127 (Januária)
Punto ALiB: 128 (Janaúba)
Punto ALiB: 129 (Pedra Azul)
Punto ALiB: 130 (Unaí)
Punto ALiB: 131 (Montes Claros)
Punto ALiB: 132 (Pirapora)
Punto ALiB: 133 (Teófilo Otoni)
Punto ALiB: 134 (Diamantina)
Punto ALiB: 135 (Uberlândia)
Punto ALiB: 136 (Patos de Minas)
Punto ALiB: 137 (Campina Verde)
Punto ALiB: 138 (Belo Horizonte)
Punto ALiB: 139 (Ipatinga)
Punto ALiB: 140 (Passos)
Punto ALiB: 141 (Formiga)
Punto ALiB: 142 (Ouro Preto)
Punto ALiB: 143 (Viçosa)
Punto ALiB: 144 (Lavras)
Punto ALiB: 145 (São João del Rei)
Punto ALiB: 146 (Muriaé)
Punto ALiB: 147 (Poços de Caldas)
Punto ALiB: 148 (Juiz de Fora)
Punto ALiB: 149 (Itajubá)
Punto ALiB: 150 (Jales)
Punto ALiB: 151 (Votuporanga)
Punto ALiB: 152 (São José do Rio Preto)
Punto ALiB: 153 (Barretos)
Punto ALiB: 154 (Franca)
Punto ALiB: 155 (Andradina)
Punto ALiB: 156 (Araçatuba)
Punto ALiB: 157 (Ribeirão Preto)
Punto ALiB: 158 (Lins)
Punto ALiB: 159 (Ibitinga)
Punto ALiB: 160 (Mococa)
Punto ALiB: 161 (Presidente Epitácio)
Punto ALiB: 162 (Adamantina)
Punto ALiB: 163 (Araraquara)
Punto ALiB: 164 (Teodoro Sampaio)
Punto ALiB: 165 (Presidente Prudente)
Punto ALiB: 166 (Marília)
Punto ALiB: 167 (Bauru)
Punto ALiB: 168 (Moji Mirim)
Punto ALiB: 169 (Assis)
Punto ALiB: 170 (Bernardino de Campos)
Punto ALiB: 171 (Botucatu)
Punto ALiB: 172 (Piracicaba)
Punto ALiB: 173 (Campinas)
Punto ALiB: 174 (Bragança Paulista)
Punto ALiB: 175 (Taubaté)
Punto ALiB: 176 (Guaratinguetá)
Punto ALiB: 177 (Itapetininga)
Punto ALiB: 178 (Sorocaba)
Punto ALiB: 179 (São Paulo)
Punto ALiB: 180 (Caraguatatuba)
Punto ALiB: 181 (Itararé)
Punto ALiB: 182 (Capão Bonito)
Punto ALiB: 183 (Itanhaém)
Punto ALiB: 184 (Santos)
Punto ALiB: 185 (Ribeira)
Punto ALiB: 186 (Registro)
Punto ALiB: 187 (Cananéia)
Punto ALiB: 188 (Barra de São Francisco)
Punto ALiB: 189 (São Mateus)
Punto ALiB: 190 (Vitória)
Punto ALiB: 191 (Santa Teresa)
Punto ALiB: 192 (Alegre)
Punto ALiB: 193 (Itaperuna)
Punto ALiB: 194 (São João da Barra)
Punto ALiB: 195 (Campos dos Goytacazes)
Punto ALiB: 196 (Três Rios)
Punto ALiB: 197 (Nova Friburgo)
Punto ALiB: 198 (Macaé)
Punto ALiB: 199 (Valença)
Punto ALiB: 200 (Petrópolis)
Punto ALiB: 201 (Nova Iguaçu)
Punto ALiB: 202 (Rio de Janeiro)
Punto ALiB: 203 (Niterói)
Punto ALiB: 204 (Arraial do Cabo)
Punto ALiB: 205 (Barra Mansa)
Punto ALiB: 206 (Parati)
Punto ALiB: 207 (Nova Londrina)
Punto ALiB: 208 (Londrina)
Punto ALiB: 209 (Terra Boa)
Punto ALiB: 210 (Umuarama)
Punto ALiB: 211 (Tomazina)
Punto ALiB: 212 (Campo Mourão)
Punto ALiB: 213 (Cândido de Abreu)
Punto ALiB: 214 (Piraí do Sul)
Punto ALiB: 215 (Toledo)
Punto ALiB: 216 (Adrianópolis)
Punto ALiB: 217 (São Miguel do Iguaçu)
Punto ALiB: 218 (Imbituva)
Punto ALiB: 219 (Guarapuava)
Punto ALiB: 220 (Curitiba)
Punto ALiB: 221 (Morretes)
Punto ALiB: 222 (Lapa)
Punto ALiB: 223 (Barracão)
Punto ALiB: 224 (Porto União)
Punto ALiB: 225 (São Francisco do Sul)
Punto ALiB: 226 (São Miguel do Oeste)
Punto ALiB: 227 (Blumenau)
Punto ALiB: 228 (Itajaí)
Punto ALiB: 229 (Concórdia)
Punto ALiB: 230 (Florianópolis)
Punto ALiB: 231 (Lages)
Punto ALiB: 232 (Tubarão)
Punto ALiB: 233 (Criciúma)
Punto ALiB: 234 (Três Passos)
Punto ALiB: 235 (Erechim)
Punto ALiB: 236 (Passo Fundo)
Punto ALiB: 237 (Vacaria)
Punto ALiB: 238 (Ijuí)
Punto ALiB: 239 (São Borja)
Punto ALiB: 240 (Flores da Cunha)
Punto ALiB: 241 (Santa Cruz do Sul)
Punto ALiB: 242 (Santa Maria)
Punto ALiB: 243 (Porto Alegre)
Punto ALiB: 244 (Osório)
Punto ALiB: 245 (Uruguaiana)
Punto ALiB: 246 (Caçapava do Sul)
Punto ALiB: 247 (Santana do Livramento)
Punto ALiB: 248 (Bagé)
Punto ALiB: 249 (São José do Norte)
Punto ALiB: 250 (Chuí)
VA-ID: A60960 (Mosogno)
VA-ID: A72886 (Oberperfuss)
VA-ID: A55050 (Aubres)
VA-ID: A53754 (Le Noyer (Hautes-Alpes))
VA-ID: A60117 (Splügen)
VA-ID: A19522 (Luserna)
VA-ID: A60580 (Kaltbrunn)
VA-ID: A72494 (Untertauern)
VA-ID: A53469 (Rimplas)
VA-ID: A73277 (Dravograd)
VA-ID: A72732 (Scheifling)
VA-ID: A56890 (Villaroux)
VA-ID: A55571 (Saint-Mury-Monteymond)
VA-ID: A72490 (Sankt Johann im Pongau)
VA-ID: A56742 (Cléry (Savoie))
VA-ID: A55458 (Desingy)
VA-ID: A55518 (Bellevaux)
VA-ID: A60934 (Quinto)
VA-ID: A54908 (Saou)
VA-ID: A17741 (Pella)
VA-ID: A17905 (Luserna San Giovanni)
VA-ID: A17385 (Netro)
VA-ID: A59571 (Beatenberg)
VA-ID: A60981 (Barbengo)
VA-ID: A65058 (Unterthingau)
VA-ID: A55582 (Seyssinet-Pariset)
VA-ID: A53673 (Montbrand)
VA-ID: A56946 (Saint-Georges-des-Hurtières)
VA-ID: A60160 (Untervaz)
VA-ID: A15240 (Lovere)
VA-ID: A56855 (Belmont-Tramonet)
VA-ID: A55520 (Lyaud)
VA-ID: A55350 (Cluses)
VA-ID: A55656 (Saint-Baudille-et-Pipet)
VA-ID: A72537 (Viehhofen)
VA-ID: A73162 (Langen bei Bregenz)
VA-ID: A19406 (Val Di Vizze)
VA-ID: A71218 (Kobersdorf)
VA-ID: A60153 (Igis)
VA-ID: A53698 (Pelleautier)
VA-ID: A55516 (Seytroux)
VA-ID: A60607 (Wildhaus)
VA-ID: A15606 (Cavargna)
VA-ID: A15613 (Colonno)
VA-ID: A14402 (Forgaria Nel Friuli)
VA-ID: A17488 (Celle Di Macra)
VA-ID: A19740 (Bard (Aosta))
VA-ID: A64848 (Raubling)
VA-ID: A65738 (Unterammergau)
VA-ID: A19853 (San Tomaso Agordino)
VA-ID: A56985 (Pontamafrey-Montpascal)
VA-ID: A54996 (Dieulefit)
VA-ID: A20345 (Posina)
VA-ID: A55717 (Sarcenas)
VA-ID: A53385 (Le Tignet)
VA-ID: A71374 (Sittersdorf)
VA-ID: A19357 (Naturno)
VA-ID: A53402 (Coaraze)
VA-ID: A19505 (Giovo)
VA-ID: A64625 (Bergen (Traunstein))
VA-ID: A18103 (Cesara)
VA-ID: A15296 (Roncola)
VA-ID: A55198 (Rochechinard)
VA-ID: A60226 (Andiast)
VA-ID: A15403 (Cedegolo)
VA-ID: A54943 (Volvent)
VA-ID: A17773 (Alpette)
VA-ID: A53178 (Moriez)
VA-ID: A17941 (Oulx)
VA-ID: A72389 (Unterach am Attersee)
VA-ID: A53369 (Aiglun (Alpes-Maritimes))
VA-ID: A53291 (Ganagobie)
VA-ID: A53461 (Isola)
VA-ID: A72934 (Sankt Ulrich am Pillersee)
VA-ID: A60063 (Walensee)
VA-ID: A55583 (Seyssins)
VA-ID: A55706 (Montfalcon)
VA-ID: A16475 (Madesimo)
VA-ID: A53631 (Aiguilles)
VA-ID: A16556 (Cassano Valcuvia)
VA-ID: A72910 (Völs)
VA-ID: A19403 (Tubre)
VA-ID: A55590 (Le Cheylas)
VA-ID: A56737 (Montagny (Savoie))
VA-ID: A15111 (Villanova d'Albenga)
VA-ID: A61631 (Rossinière)
VA-ID: A54004 (Cabrières-d'Aigues)
VA-ID: A73078 (Gerlosberg)
VA-ID: A55749 (Murinais)
VA-ID: A53323 (Aubignosc)
VA-ID: A53970 (Saint-Saturnin-lès-Apt)
VA-ID: A64607 (Kirchanschöring)
VA-ID: A15446 (Lodrino (Brescia))
VA-ID: A15859 (Cesana Brianza)
VA-ID: A19868 (Valle Di Cadore)
VA-ID: A60959 (Minusio)
VA-ID: A17798 (Borgone Susa)
VA-ID: A53960 (Apt)
VA-ID: A73123 (Nenzing)
VA-ID: A72855 (Axams)
Brasile
Perimetro della "Convenzione delle Alpi"
3. Perspektiven einer universalen Datenintegration
Im Folgenden wollen wir zeigen, wie man die Sache in einem größeren Rahmen angehen *könnte*. Es handelt sich ausdrücklich um einen Vorschlag. Die Umsetzung ist ohne den entsprechenden Kooperationswillen der auf dem Feld der Geolinguistik tätigen Akteure nicht machbar. Hilfreich wären entsprechende Absichtsbekundungen und zu gegebener Zeit ein Treffen, bei dem sich die Beteiligten auf ein verbindliches Regelwerk einigen würden.
3.1. Verbindliche Datenstrukturen
Damit Daten projektübergreifend ausgetauscht oder von zentraler Stelle analysiert werden können, ist eine verbindliche Datenstruktur unverzichtbar. Eine solche verbindliche Struktur muss *nicht* die primäre Struktur innerhalb eines jeden teilnehmenden Projekts sein. Bei Bedarf kann diese Struktur auch über ein individuelles Mapping erzeugt werden. Die Erzeugung von Datenstrukturen oder Mapping-Prozeduren ist heute dank KI mit deutlich geringerem personellen und zeitlichen Aufwand als früher zu bewältigen.
Absolut grundlegend erscheint eine möglichst feine Granulierung jedweden Sprachmaterials. Als kleinste Einheit und gleichsam als 'Referenzentität' bieten sich die grammatischen Wörter eines Textes an.
Im Detail entsteht an dieser Stelle Regelungsbedarf. So müsste beispielsweise geklärt werden, wie mit apostrophierten und kontrahierten Formen sowie mit Klitika umzugehen ist. Man denke an Schreibungen wie dall'inizio oder raccontamelo. Wir unterscheiden hier zwischen orthographischen Einheiten und grammatischen Wörtern. Die orthographische Einheit raccontamelo setzt sich aus den grammatischen Wörtern racconta, me und lo zusammen.
Problematisch sind auch die Satzzeichen, die meist unmittelbar an Wörter angehängt sind.
Im folgenden Beispiel werden, zur Verdeutlichung des Prinzips, die Spazien durch das Zeichen ⎵ repräsentiert. Als zusätzliche Separatoren, die eine von der Standardorthographie abweichende Segmentierung erzeugen, finden Pluszeichen (+) Anwendung. Die Unterscheidung zwischen Spatien und Pluszeichen als Separatoren gewährleistet die spätere Rekonstruktion des ursprünglichen Fließtexts in Standardorthographie. Obgleich keine grammatischen 'Wörter', werden Interpunktionszeichen rein technisch wie solche behandelt und bei der Segmentierung durch Einfügung von Separatoren (+) isoliert.
Dall'inizio,⎵raccontamelo⎵lentamente,⎵perché⎵non⎵l'ho⎵capito.

Da+ll‘+inizio+,⎵racconta+me+lo⎵lentamente+,⎵perché⎵non⎵l‘+ho⎵capito+.
Die Regeln einer solchen Segmentierung können im Detail durchaus unterschiedlich sein. So kann man z. B. hinsichtlich des Umgangs mit Apostrophen unterschiedlicher Auffassung sein. Auch wäre vorstellbar, preposizioni articolate nicht in ihre Bestandteile zu zerlegen, sondern jeweils als eigene grammatische Wörter zu betrachten, die später ihre eigene angemessene Etikettierung erhalten. Vorstellbar wäre auch eine noch feinere Granulierung, etwa bis zur Ebene von Morphemen oder Silben. Hinzu kommt, dass verschiedene Sprachen unterschiedliche Anforderungen stellen.
Dieser Beitrag ist auf das Italienische fokussiert, das Vorgehen ist aber grundsätzlich auf beliebige andere Sprachen übertragbar, namentlich die romanischen Sprachen dürften diesbezüglich keinerlei systematische Schwierigkeit bereiten. Die Festlegung solcher dann verbindlichen Segmentierungsregeln wäre eine Aufgabe eines Konsortiums, das von Akteuren aus dem Bereich der Geolinguistik gebildet werden sollte.
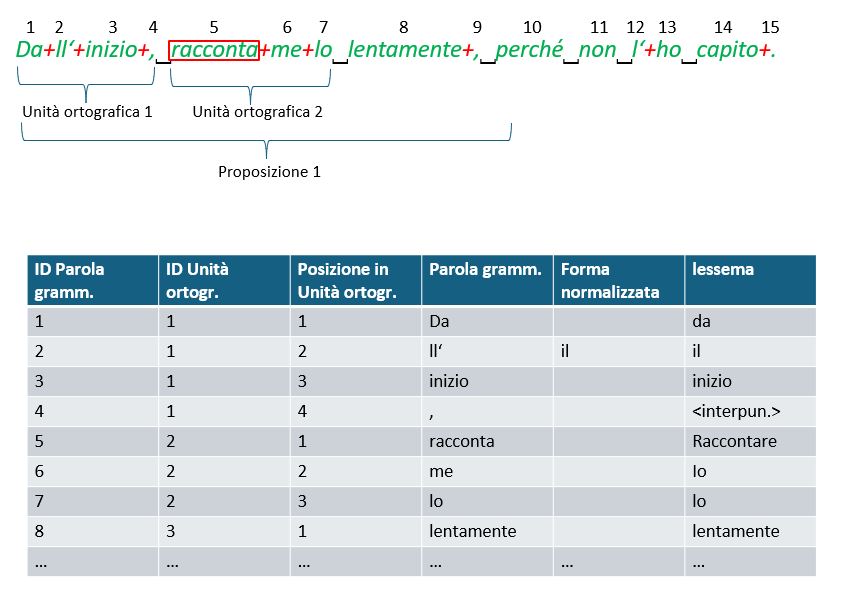
Beispiel einer möglichen Datensegmentierung samt Referenzsystem
Um aus den segmentierten Elementen eines Texts jederzeit den ursprünglichen Fließtext wiederherstellen zu können, ist ein sog. Referenzsystem unverzichtbar. Für jede einzelne grammatische Einheit muss die Information gespeichert werden, aus welchem Text sie stammt und an welcher Stelle innerhalb dieses Textes sie steht. Auch die Metadaten des Gesamttextes müssen dokumentiert und zugänglich sein.
Die in dieser Weise strukturierten Daten können in unterschiedlichen Datenformaten gespeichert werden. In Abbildung sind die Daten im relationalen Format gespeichert, grundsätzlich möglich sind jedoch auch andere Formate wie z. B. JSON oder XML. Bestehende Datenformate können stets mit Hilfe von Scripts in im Grunde beliebige andere Formate transformiert werden.
Bei Vorhandensein eines sauberen Referenzsystems können einmal tokenisierte Texte problemlos zu den ursprünglichen größeren Einheiten, also Sätzen, Absätzen oder auch den vollständigen Gesamttexten re-synthetisiert werden. Und natürlich ist, bei Bedarf, auch eine weitere Granulierung der Wörter, in beliebige morphologische oder phonetische Einheiten, jederzeit möglich. Im Sinne projektübergreifenden Datenaustauschs sollte in jedem Fall eine möglichst feingranulare Segmentierung verbindlich vereinbart werden. Eine Segmentierung in grammatische Wörter bietet sich dabei als Referenz- bzw. Standardsegmentierung an.
Die Textsegmentierung nach Maßgabe grammatischer Wörter ist per se nicht neu. Entsprechende Regelwerke waren bereits in den 1990er Jahren als sog. Corpus Encoding Standard (CES) oder, etwas jünger und nunmehr aktuell, von der Text Encoding Initiative (TEI) definiert worden. Letztlich geht es nur um eine möglichst universelle fachinterne Einigung der auf dem Gebiet tätigen Akteure.
Das entsprechende Datenmodell sollte auf die meisten Sprach- und Textsammlungen anwendbar sein. Es macht keinen Unterschied, ob es sich um hochstrukturierte lexikalische Korpora oder um Sammlungen diskursiver Inhalte handelt.
Bei einer morphosyntaktischen Etikettierung des Sprachmaterials sollten die im Bereich der Romanistik üblichen Merkmale (Genus, Numerus, Tempus, Modus etc.) und deren Ausprägungen angewandt werden. Höchste Priorität sollten dabei eine Lemmatisierung der Wörter sowie die Angabe der Wortart erhalten.
Sofern die Art des Datenbestands und die verfügbaren Ressourcen es zulassen, sollte eine Typisierung des Korpusmaterials erfolgen. Letztlich ist bereits die Lemmatisierung eine Bündelung eines strukturierten Korpusmaterials. Der entscheidende Schritt besteht darin, dem Lemma eine eigene Identität zu verleihen und diese mit einem spezifischen Identifikator zu versehen. Typisierungen sind ferner u.a. im Hinblick auf orthographische oder phonetische Variationen sinnvoll.
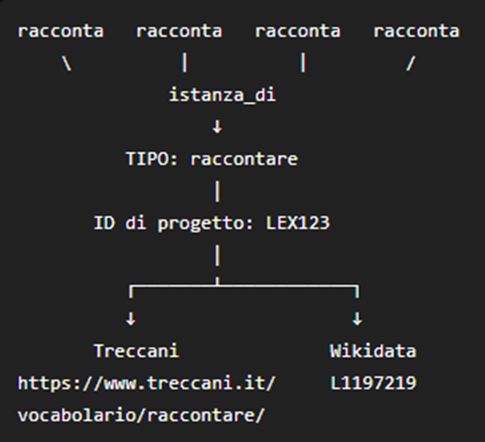
Bündelung von in einem Korpus verteilten Formen des Verbs "raccontare" durch Zuweisung zum entsprechenden Lemma sowie Zuordnung zu externen Identifikatoren.
Die projektspezifischen Identifikatoren können sodann korrespondierenden externen Identifikatoren zugeordnet werden. Im Beispiel in Abbildung sind dies die Identifikatoren des Vocabolario der Treccani (raccontare) sowie der Lexem-Sektion von Wikidata (L1197219).
In gewissem Sinn kann man auch die Einbringung einer semantischen Systematik in einen Datenbestand als eine Art Typisierung auffassen. In mehrsprachigen Korpora lassen sich sprachspezifische, aber bedeutungsidentische Lexeme bündeln, indem sie jeweils dem identischen Konzept zugeordnet werden, das sie bezeichnen (s. DEFAULT).
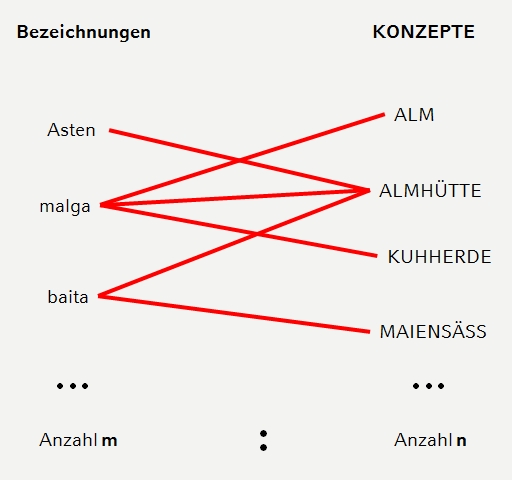
Bündelung der Lexeme 'Asten', 'malga' und 'baita' durch Zuordnung zum gemeinsamen Konzept ALMHÜTTE
Grundsätzlich sind projektspezifische Kategorisierungen unterschiedlicher Art vorstellbar und möglich. Jeder Instanz einer solchen Kategorie müssten wiederum IDs zugewiesen werden. Unverzichtbar wäre jeweils eine detaillierte Dokumentation, die die Definition der Entitäten beschreibt.
Die IDs der orthographischen oder grammatischen Wörter würden im Bedarfsfall auch die Etikettierung syntaktischer Einheiten erlauben, indem sie zu Gruppen verbunden und die Gruppen sodann im Grunde beliebigen Kategorien (z.B. 'finaler Nebensatz', 'Nominalgruppe' o. ä.) zugewiesen werden (s. DEFAULT).
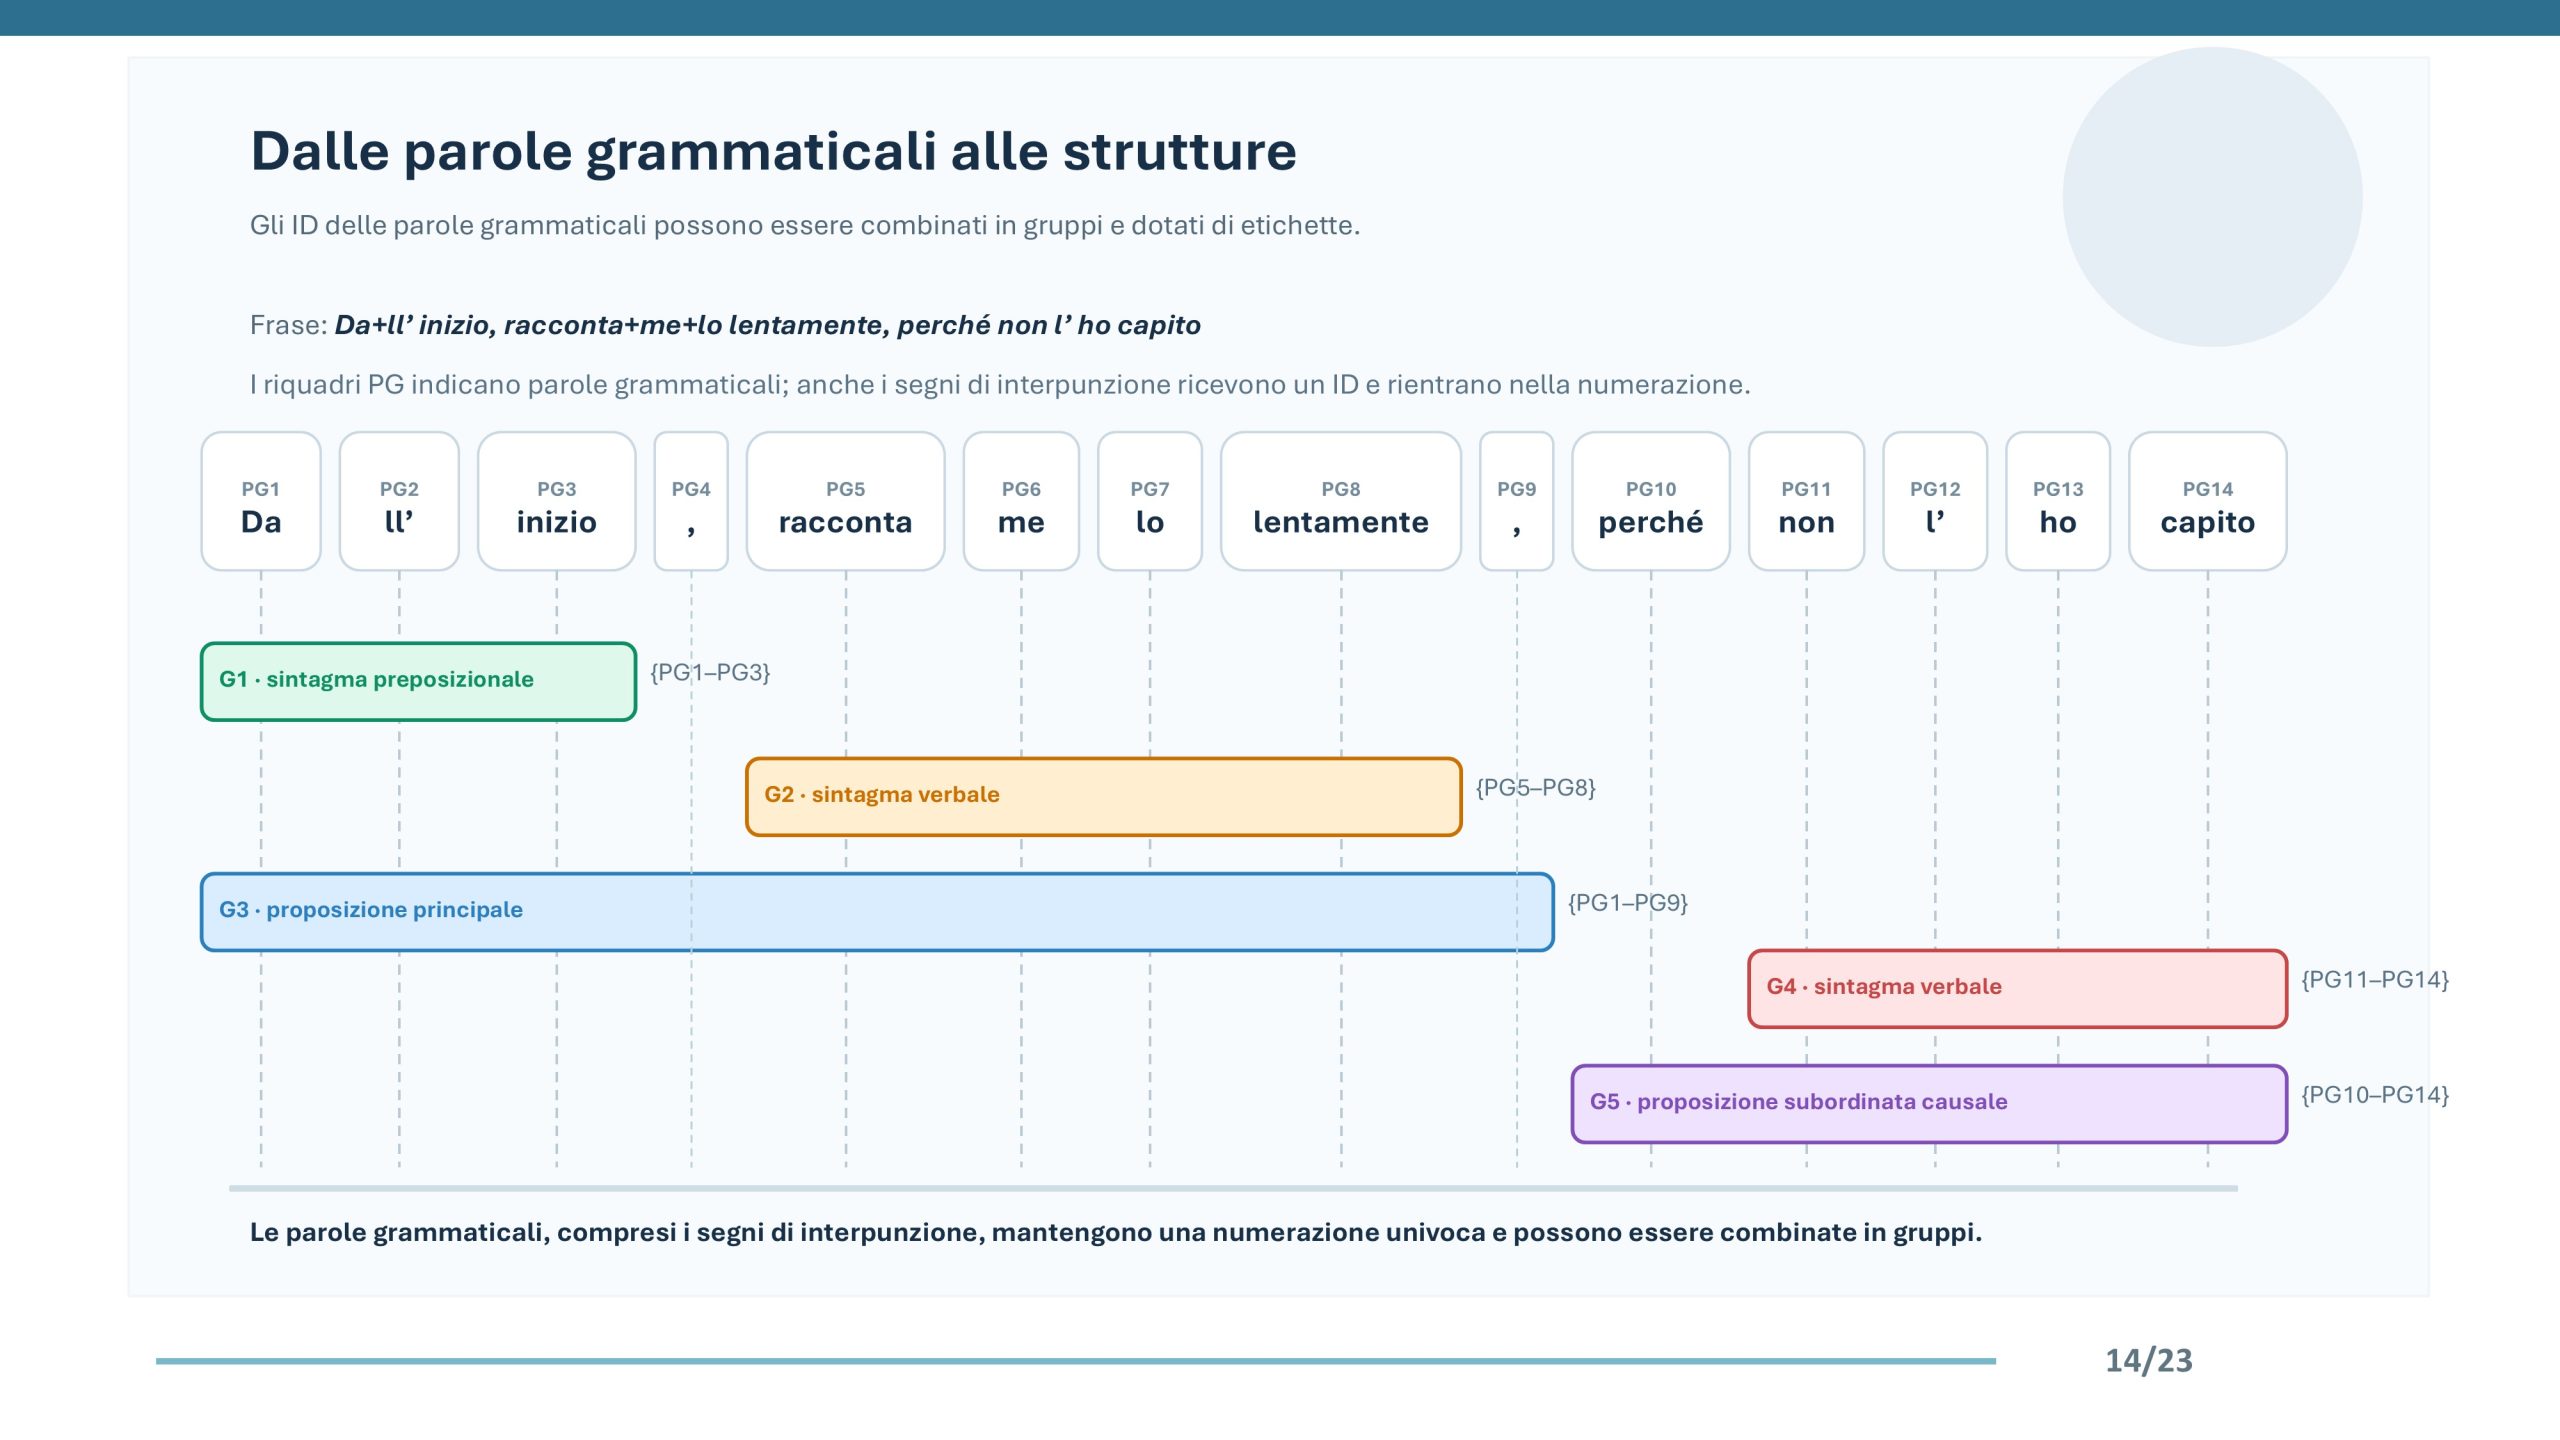
Definition von Syntagmen durch Kombination der IDs mehrerer grammatischer Wörter
Das vorgeschlagene Modell setzt nicht zwingend das Vorhandensein eines Textkorpus voraus. Projekte, die unmittelbar sprachliche Typen dokumentieren, können auf die Ebene der Einzelbelege beziehungsweise Textinstanzen verzichten. Projektspezifische Identifikatoren und Verknüpfungen mit externen Ressourcen bleiben dennoch uneingeschränkt nutzbar.
3.2. Stabilität und Zitierbarkeit
Digitalität bringt bei allen Vorteilen auch Herausforderungen mit sich. Eine ganz zentrale Herausforderung ist die "Flüchtigkeit" elektronischer Inhalte. Diese Eigenheit steht dem Erfordernis wissenschaftlicher Nachvollziehbarkeit entgegen. Für jede Form wissenschaftlicher Arbeit ist letztlich die Stabilität des auf Papier gedruckten Wortes der Maßstab, hinter den auch im Umfeld digital gestützter Forschung nicht zurückgefallen werden darf.
Gleichzeitig stellt die Veränderbarkeit digitaler Inhalte natürlich einen großen Vorteil auch für wissenschaftliche Arbeit dar. Es gilt somit, hier einen Ausgleich zwischen diesen beiden Eigenschaften digitaler Daten herzustellen.
Die nächstliegende Lösung besteht in der Implementierung eines Versionierungskonzepts. Ganze Datenbestände oder auch deren Teile können für unveränderlich erklärt, somit gleichsam 'eingefroren' werden. Freilich steht und fällt die Verlässlichkeit eines solchen Systems mit der Disziplin der die Daten verwaltenden Instanz. Eine rein technische 'Petrifizierung' digitaler Inhalte erscheint ein Ding der Unmöglichkeit.
Einmal versionierte Daten dürfen also nicht mehr verändert werden. Dies bezieht sich auch auf offenkundige Fehler in den Daten. Eine Korrektur von Fehlern ist nur im noch nicht versionierten Datenbestand möglich, der parallel zu den versionierten Fassungen weiterhin besteht. Als zitierfähig können nur versionierte Bestandteile eines Datenbestands gelten.
Die Versionierung von digitalen Datenbeständen wird bereits verschiedentlich angewandt. So sind z. B. manche Bereiche des Wikimedia-Universums mit einem Versionierungskonzept versehen. Dies gilt etwa für 'items' von Wikidata oder für die Artikel der Wikipedia. Nach jeder Änderung eines Eintrags wird dort der letzte Stand des Inhalts *vor* der Änderung als unveränderliche Version abgelegt und mit einem eigenen persistenten Identifikator versehen, der als Parameter "oldid" an die URL des entsprechenden Eintrags angehängt wird (s. DEFAULT).
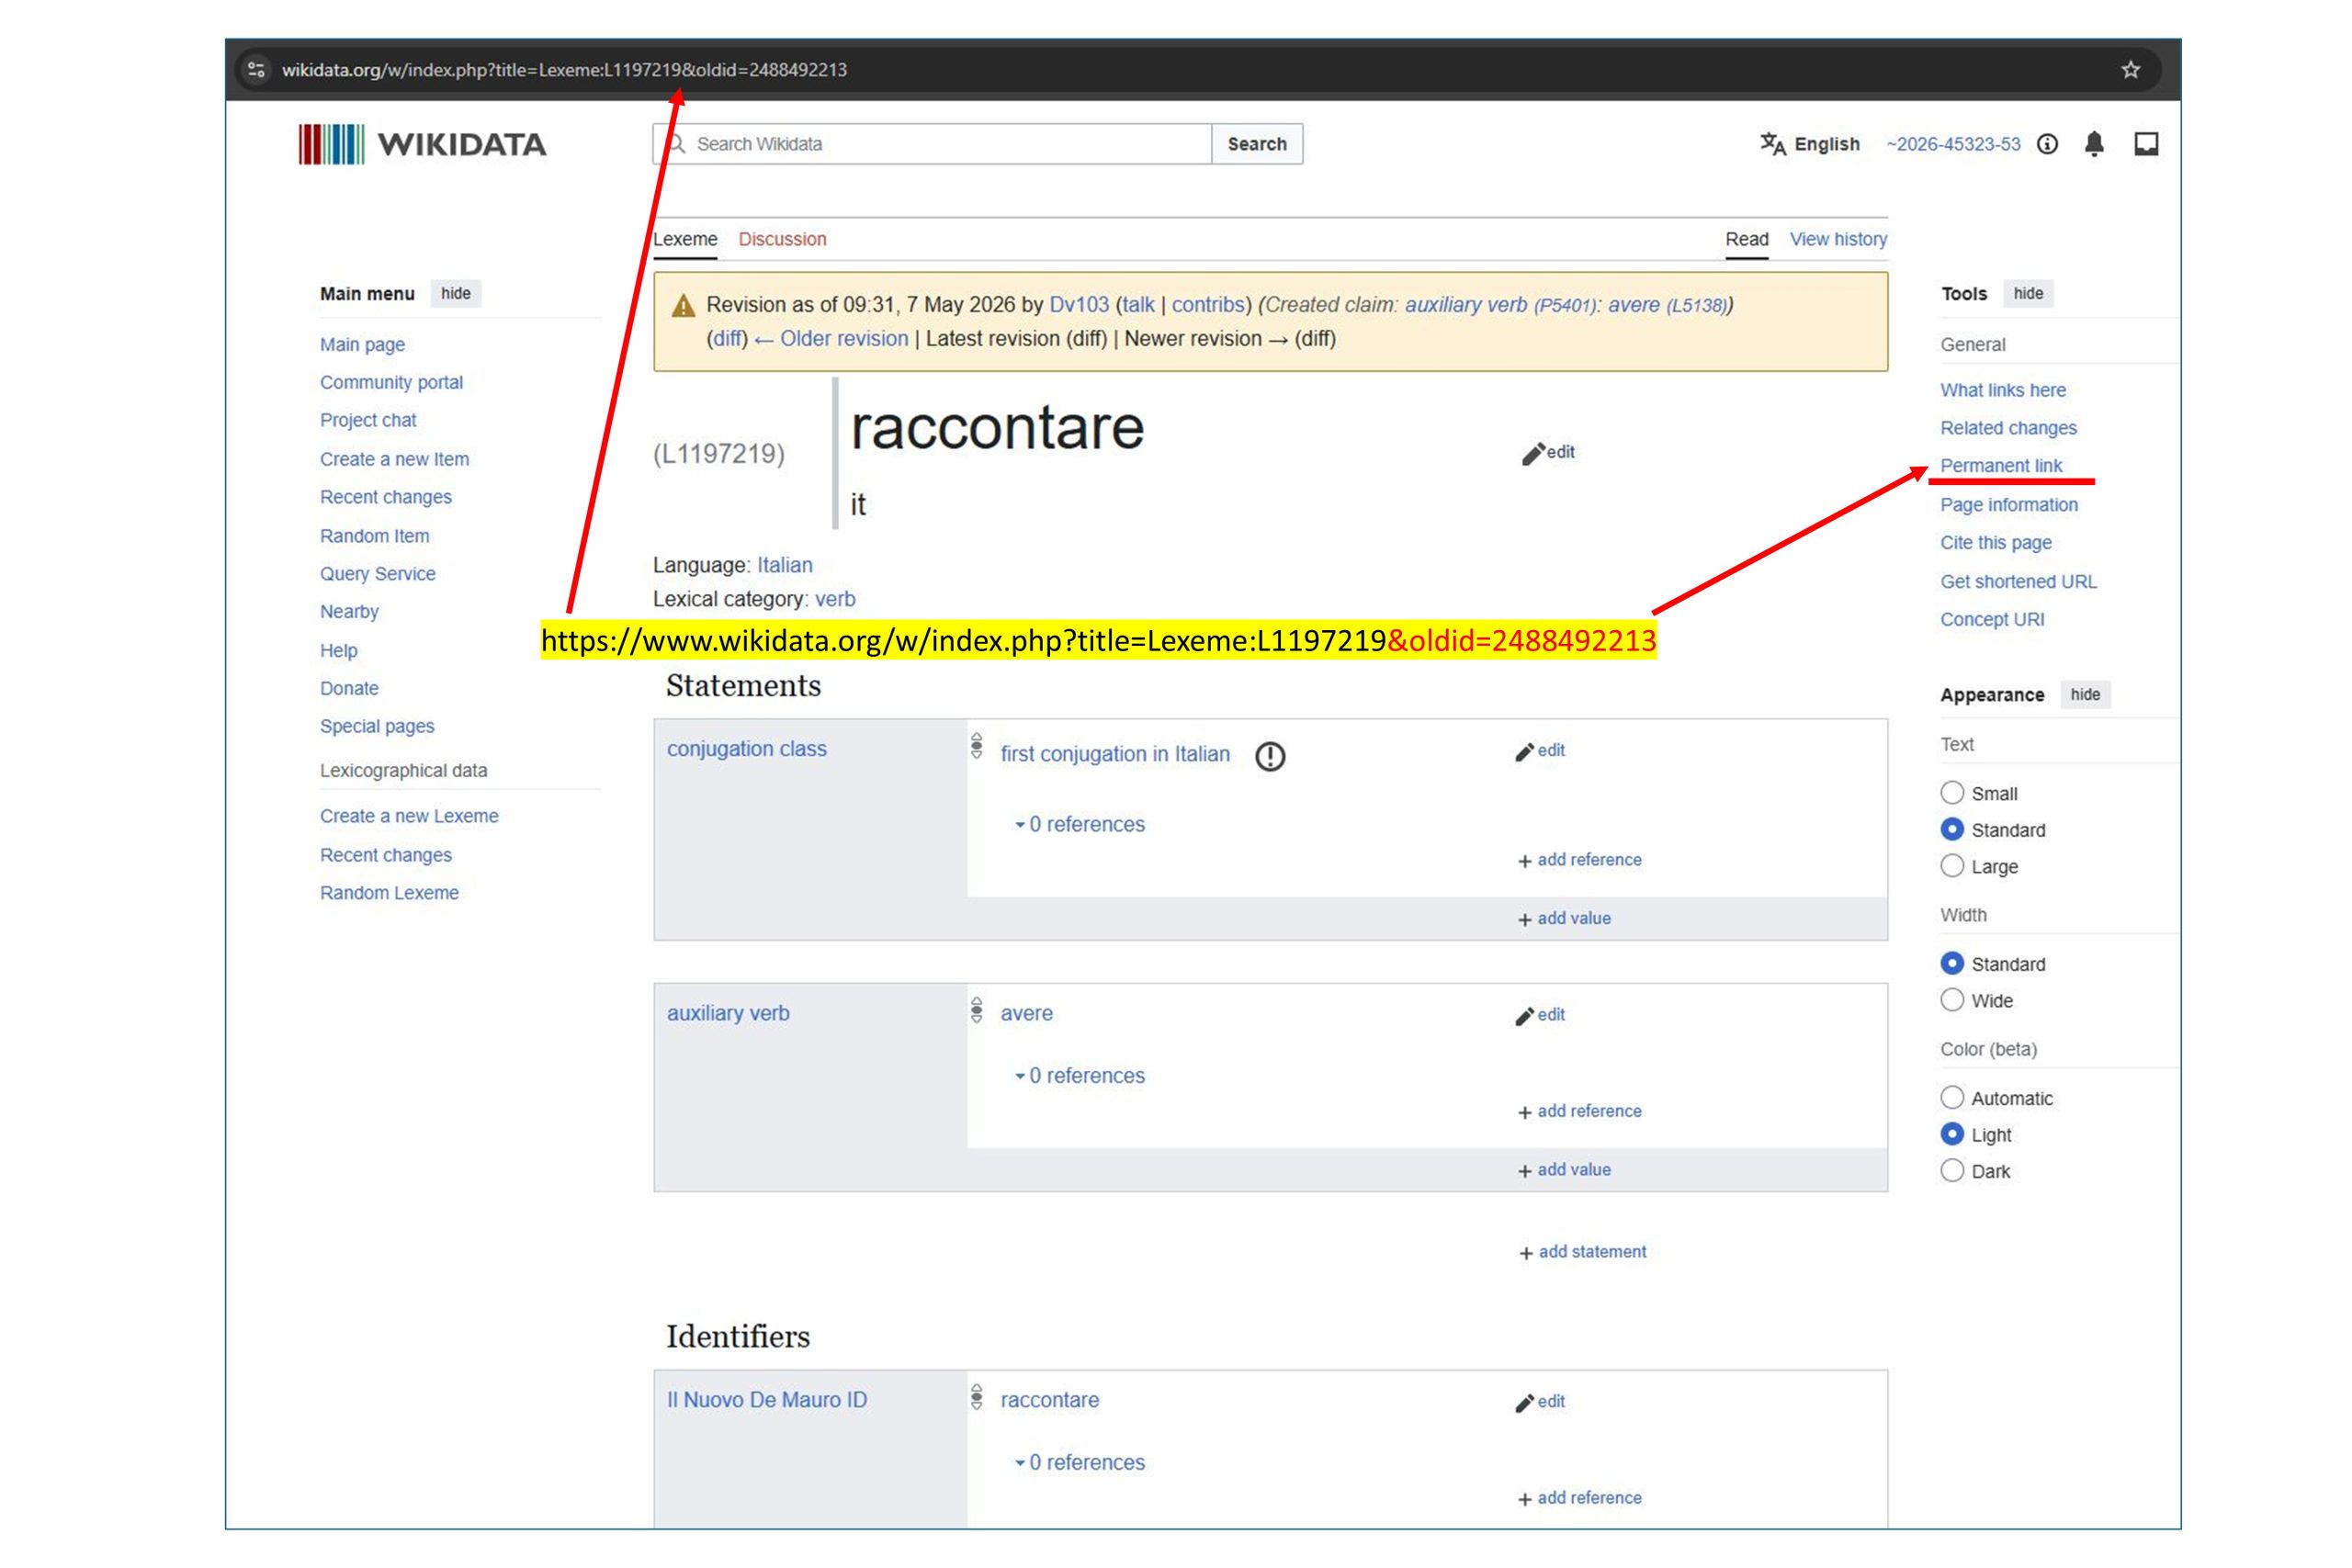
Zitierfähige Version des Eintrags "raccontare" in der lexikographischen Sektion von Wikidata ("lexemes")
Auch VerbaAlpina hat seine Daten in einem 6-Monate-Rhythmus versioniert. Rein technisch erfolgte dies durch die Anfertigung einer Kopie der zentralen MySQL-Datenbank, deren Name dann die Versionsnummer als Suffix hinzugefügt wurde. Das Projektportal erlaubt den Wechsel zwischen den unterschiedlichen Versionen des Datenbestands. Die sprachlichen Kerndaten des Projekts sind überdies versionsgenau über spezifische Internetadressen ansprechbar (s. DEFAULT).
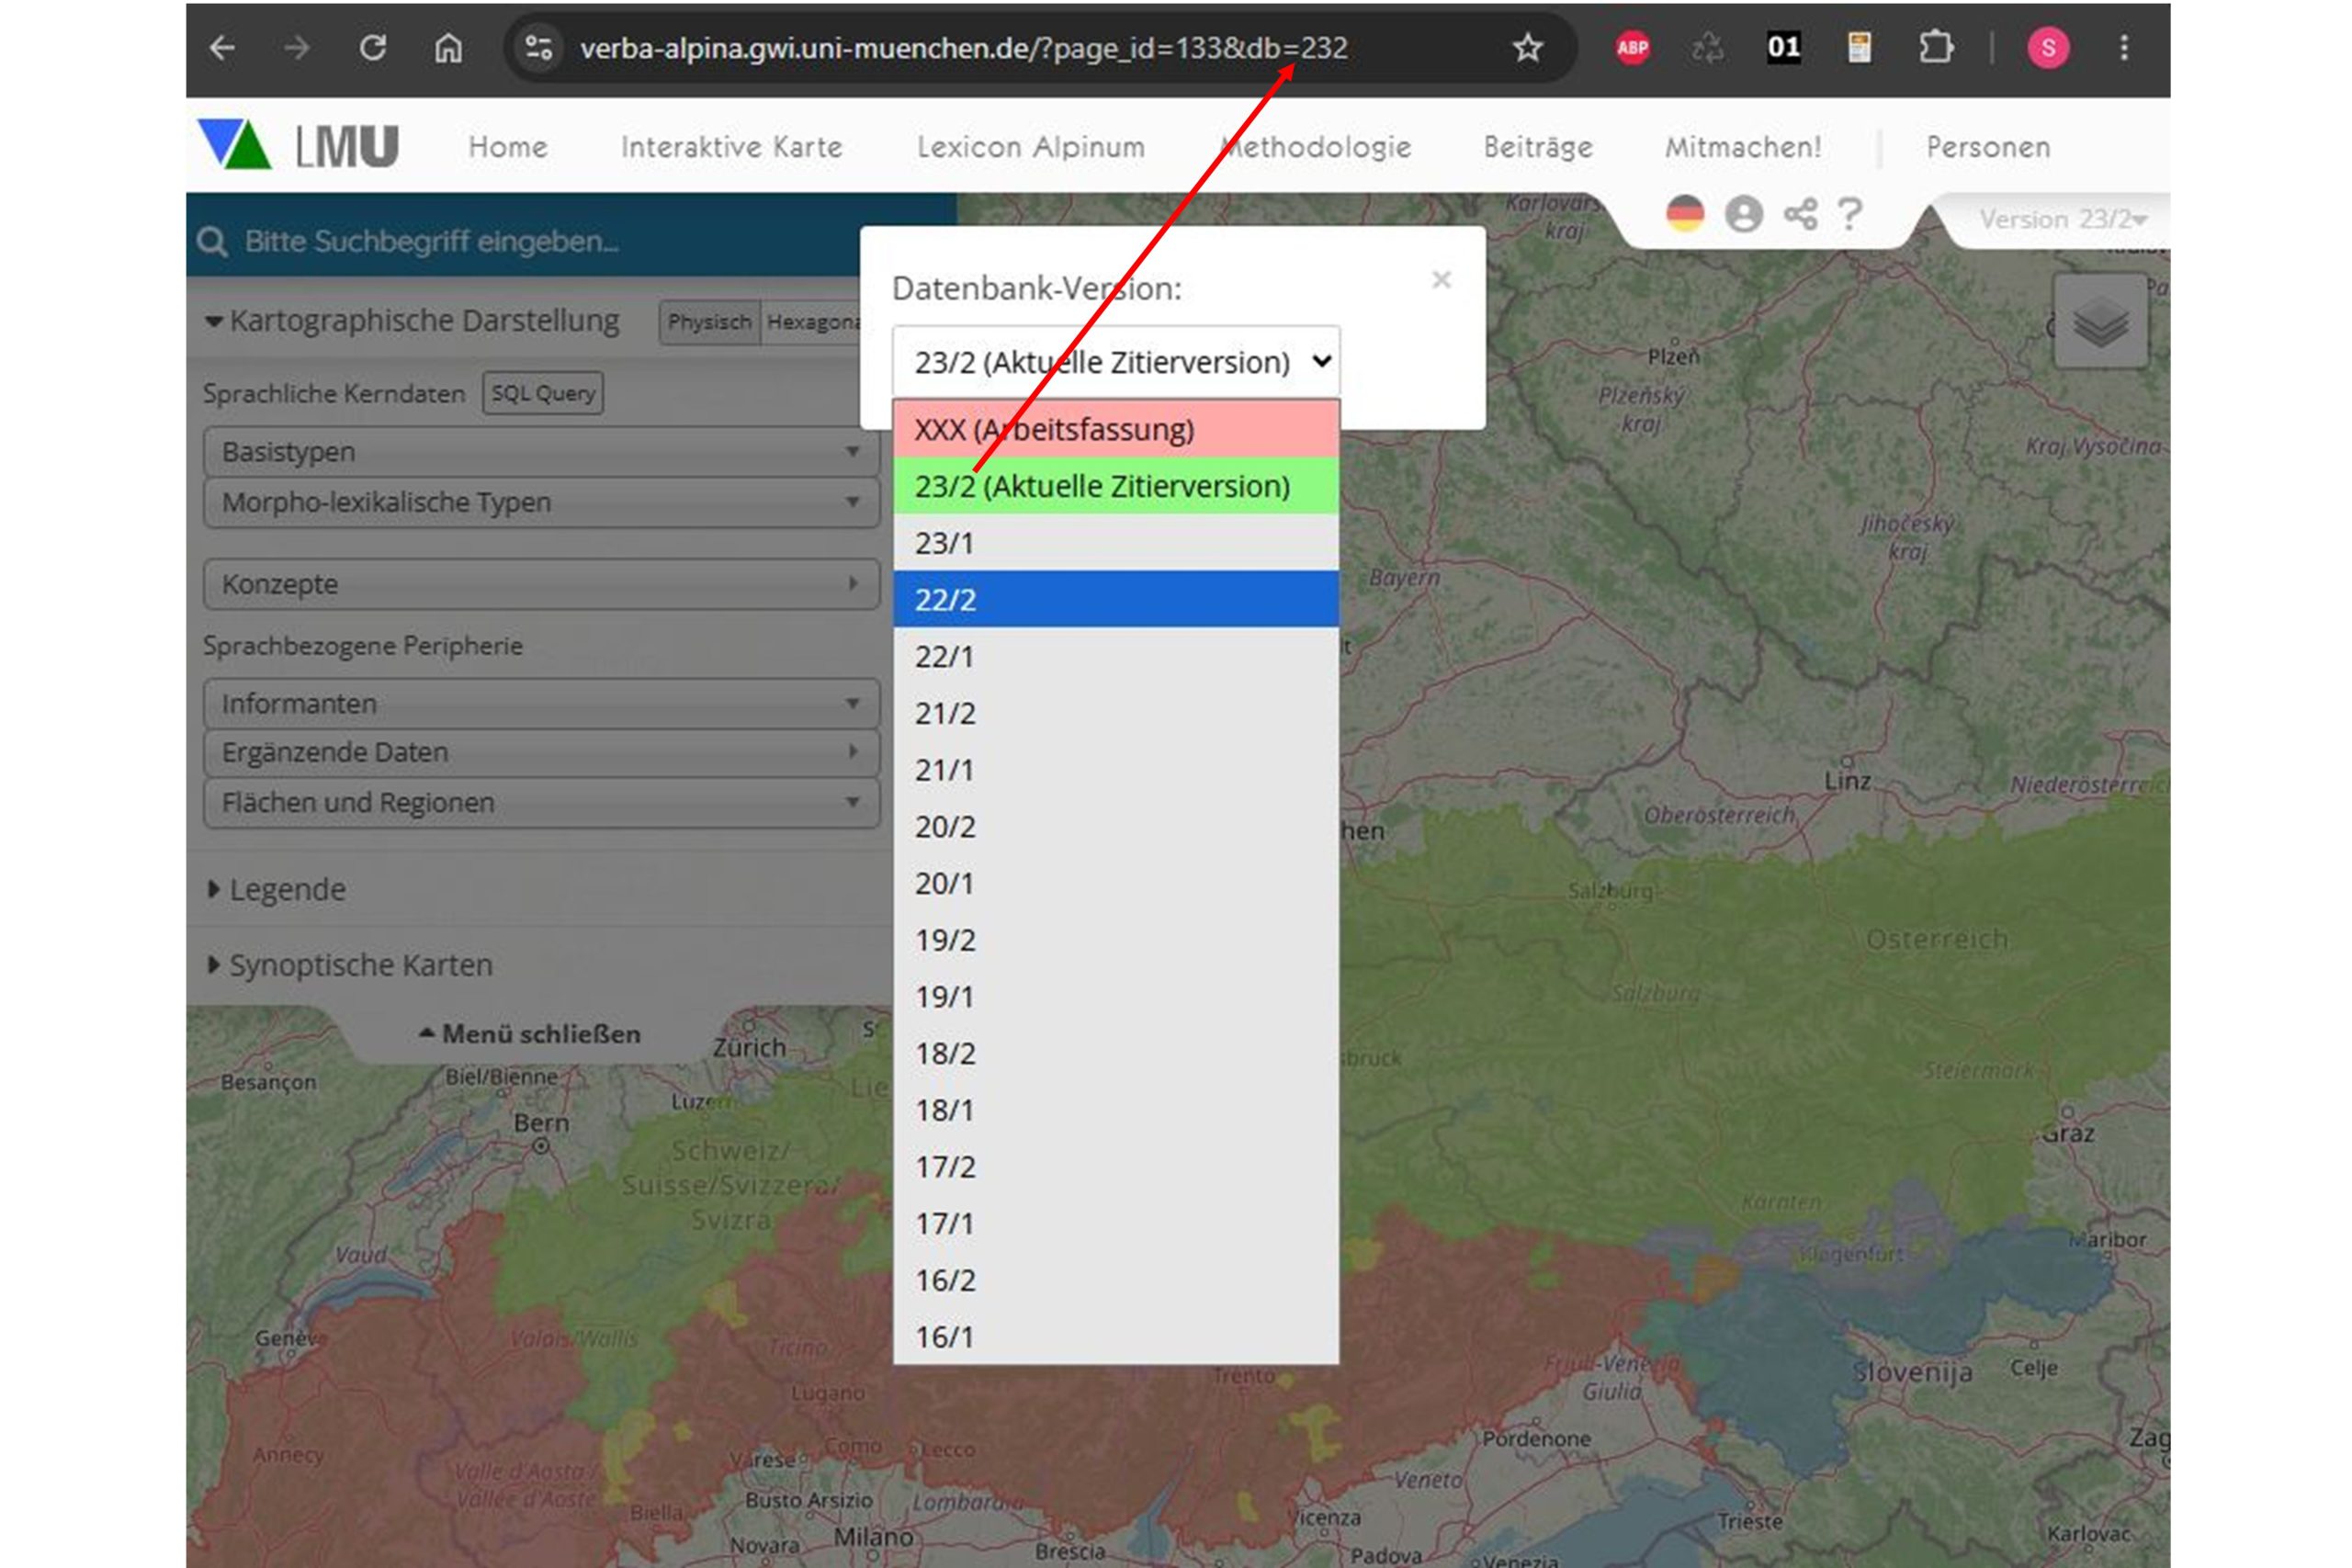
Menü für die Auswahl einer Version von VerbaAlpina. Die Versionsnummer steht für Jahr und Halbjahr der Versionserzeugung (232 = 2. Halbjahr des Jahres 2023).
3.3. Vernetzung
Entscheidender Mehrwert entsteht durch die elektronische Verknüpfbarkeit digitaler Inhalte. Im vorliegenden Szenario ist dabei die möglichst zielgenaue Adressierbarkeit der definierten sprachlichen Einheiten unverzichtbar.
Jedem grammatischen Wort als elementarer Instanz eines Korpus', ebenso wie ggf. definierten Typen, sollte ein eindeutiger und unveränderlicher Identifikator sowie eine ID-spezifische Internetadresse (URL und/oder DOI) zugewiesen werden, die zwischen einer für den Menschen lesbaren Repräsentation und einer für den maschinellen Zugriff optimierten Schnittstelle unterscheidet. Ein vorstellbares Muster wäre etwa:
progetto.xy/{id}progetto.xy/api/{id}
Im Fall lexikalischer Daten ist die Einbindung der Semantik im Grunde unverzichtbar. Damit eröffnet sich eine zweite, außersprachliche Ebene, die mit den grammatischen Wörtern in Verbindung gebracht werden muss. Hier empfiehlt sich der Aufbau einer projektspezifischen Ontologie, deren Einträge wiederum mit persistenten Identifikatoren versehen werden. Diese IDs sollten durch ein spezifisches Präfix (z. B. "C" für concetto) von den IDs der Lexeme unterschieden werden. Zur Angabe der Bedeutung eines Lexems kann diesem dann eine C-ID zugeordnet werden.
progetto.xy/C{id}
Ganz analog dazu kann auch im Hinblick auf die Georeferenzierung von Inhalten verfahren werden. Geographische Einheiten können ebenfalls mit IDs versehen und diese dann Sprachbelegen zugeordnet werden.
progetto.xy/v={Versionsnummer}&{id}
Auch über die Benennung der Parameter in der Adresse und die jeweils zulässigen Werte in solchen Internetadressen sollte in der Fachcommunity Konsens bestehen.
Da Internetadressen in wissenschaftlichen Publikationen und externen Datenbeständen als Referenzen verwendet werden, müssen sie dauerhaft auflösbar bleiben. Als link rot bezeichnet man das Phänomen, dass veröffentlichte Internetadressen ungültig werden oder die referenzierten Inhalte nicht mehr erreichbar sind. Dies äußert sich u. a. im HTTP-Statuscode 404 (Not Found).
Davon zu unterscheiden ist der sogenannte content drift, also die Veränderung der unter einer gleichbleibenden Adresse verfügbaren Inhalte. Einmal veröffentlichte Internetadressen sollten dauerhaft auflösbar bleiben; Adressen, die auf eine bestimmte Version eines Datenbestands verweisen, müssen stets denselben Datenstand präsentieren. Änderungen am Layout sind hingegen unproblematisch, sofern die referenzierten Inhalte unverändert und eindeutig identifizierbar bleiben.
Link rot ist bedauerlicherweise ein weit verbreitetes Phänomen. Auch im Bereich der Geolinguistik lassen sich dafür Beispiele finden. Dabei werden nicht nur einzelne URLs ungültig; mitunter verschwinden sogar vollständige Projektportale. So ist beispielsweise der Vivaio Acustico delle Lingue e dei Dialetti d’Italia (VIVALDI) unter seiner lange Zeit gültigen Adresse https://www2.hu-berlin.de/vivaldi/ im Oktober 2026 jedenfalls nicht mehr verlässlich erreichbar. Eine neue öffentlich dokumentierte Adresse oder ein anderweitig zugängliches Repositorium der Projektdaten ließ sich nicht ermitteln. Solche Fälle zeigen deutlich, weshalb die dauerhafte Verfügbarkeit wissenschaftlicher Ressourcen von Anfang an institutionell und technisch abgesichert werden muss.
3.4. Metadaten und externe Normdaten
Metadaten sind für die Interpretation und Nachnutzung aller Art von Daten absolut essenziell. Im hier besprochenen Szenario gehören dazu zweifellos Informationen zur Genese der in einem Korpus versammelten Sprachdaten. Im Fall der Geolinguistik sind natürlich auch Angaben zur geographischen Herkunft der Daten bzw. ggf. der die Daten beisteuernden Informanten unverzichtbar. Sofern möglich, sollte den Daten eines Korpus auch eine Chronoreferenzierung beigegeben werden. Zu den Metadaten können im Grunde auch die Klassifizierungen und Etikettierungen der grammatischen Wörter gezählt werden.
In den Details ergibt sich zumindest theoretisch eine Fülle weiterer sinnvollerweise zu erfassender Metadaten. Idealerweise wird ein Kanon verbindlicher Metadaten vereinbart.
Optional, aber empfehlenswert, ist, sofern sinnvoll und möglich, auch die Zuordnung externer Identifikatoren (z. B. aus Wörterbüchern wie Treccani, BabelNet etc.) zu den projektspezifischen Identifikatoren. Auch sie können als Metadaten betrachtet werden und sollten dann wieder in das verbindliche Austauschformat integriert werden. Selbstverständlich muss dabei die externe Ressource zweifelsfrei identifiziert werden. Im Sinne einer möglichst umfassenden Kompatibilität und Konnektivität wäre die Vereinbarung eines Standardkanons an Referenz-Ressourcen ausgesprochen hilfreich.
4. Konzeption der Infrastruktur
4.1. Vorstellbare Szenarien
Zur Verbindung der Datenbestände verschiedener Projekte bieten sich grundsätzlich zwei Optionen an: Bilaterale Verbindungen einerseits und die Nutzung einer zentralen Instanz ('hub') andererseits - wobei eine zentrale Instanz zusätzliche bilaterale Verknüpfungen natürlich nicht auszuschließen braucht.
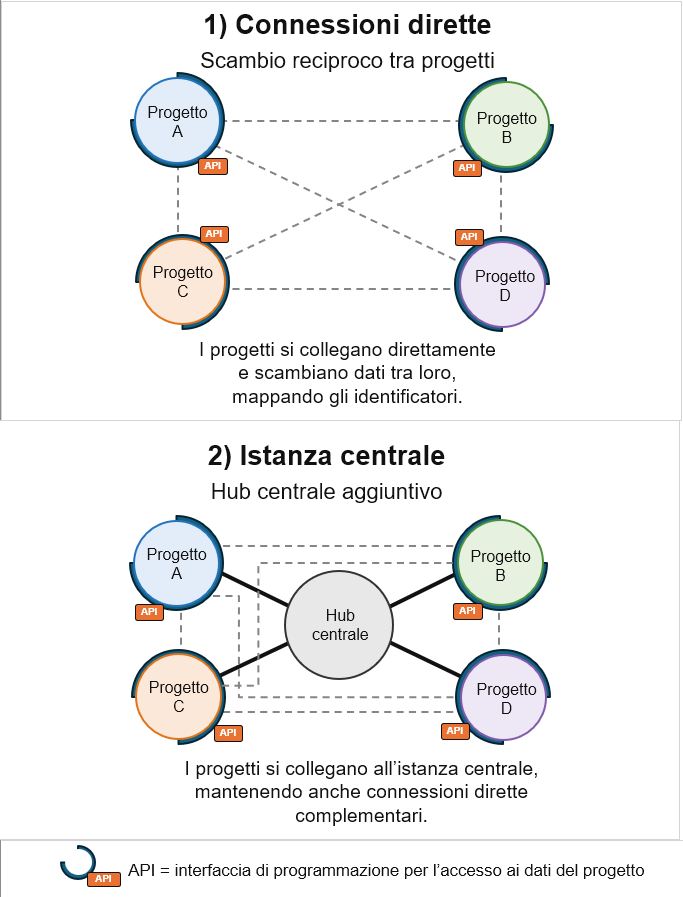
Modelle der Datenverknüpfung
Eine zentrale Instanz besitzt den Vorteil eines 'single point of access'. In einer dynamischen Forschungslandschaft ist es nicht leicht, den Überblick über bestehende einschlägige Ressourcen zu behalten. Sofern die Akteure auf dem Feld der Geolinguistik ihre Daten an ein zentrales System anbinden und diese stets aktuell halten, ist dies eine erhebliche Erleichterung für alle auf dem Gebiet der Geolinguistik Tätigen.
Einen zentralen 'Hub' würde man sich als Instanz vorstellen, die als Mittler ('broker') zwischen den angeschlossenen Ressourcen fungiert, indem sie die nötigen Identifikatoren und Klassifizierungen in einem System vereinigt und jeweils die objektgenauen Adressen der Ressourcen in Form von URLs oder DOIs gespeichert hat.
Für Betrieb und Pflege eines solchen Systems würde sich am ehesten ein über Datenstrukturen und Metadatenschema wachendes Konsortium anbieten. Freilich wären damit finanzieller und zeitlicher Aufwand verbunden, für den vermutlich nur schwer Ressourcen gefunden werden könnten.
In dem ganzen Szenario lohnt es sich vielleicht, auch die großen wissenschaftlichen Bibliotheken in den Blick zu nehmen. Sie besitzen in aller Regel eine unbefristete Bestandsperspektive und verfügen über Kompetenzen auch im Hinblick auf Langfristverfügbarkeit und Metadatenschemata. Was ihnen fehlt, ist andererseits die sprachwissenschaftliche Expertise, die in diesem Kontext natürlich unverzichtbar wäre. Hinzu kommt, dass für eine solche Aufgabe ganz allgemein die personellen und zeitlichen Kapazitäten zur Verfügung gestellt werden müssten. Eine Einbeziehung einer Bibliothek bleibt dennoch eine erwägenswerte Option.
Im Vergleich zu einer zentralistischen Lösung wäre das dezentrale Modell mit deutlich geringerem Aufwand realisierbar. Hier wäre ausreichend, wenn möglichst viele Akteure ihre Datenbestände mit einer der vorgegebenen Definition konformen API ausstatten würden. Durch den Austausch möglichst vieler Identifikatoren und einer verlässlichen Adressierbarkeit der Inhalte könnte ein Mehrwert geschaffen werden, der dem einer zentralistischen Lösung nahe käme.
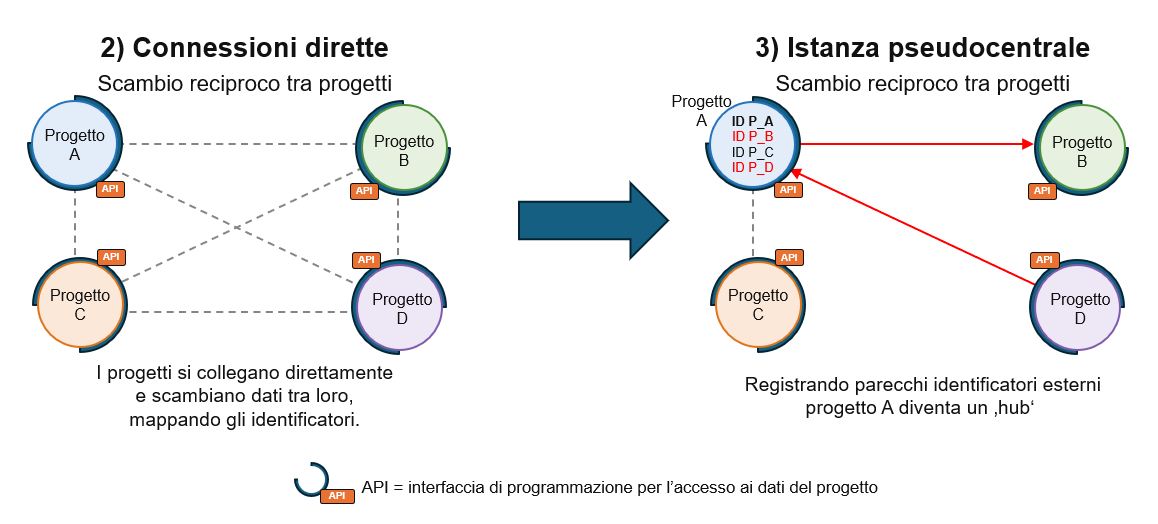
Verknüpfung von Projektdaten durch dezentrale Registrierung externer Identifikatoren, de facto Erzeugung eines 'Hubs'
4.2. Nutzung von Wikidata
4.2.1. Wikidata aus korpuslinguistischer Perspektive
Das Dilemma der Nützlichkeit eines zentralen Datenhubs für geolinguistische Korpusdaten einerseits und der Problematik der dafür erforderlichen Ressourcen andererseits ist bereits erwähnt worden.
In dieser Situation kann Wikidata, gleichsam das Backbone von Wikipedia und Teil des Wikimedia-Universums, zumindest vorübergehend und bis zu einem gewissen Grad eine interessante Zwischenlösung sein.
Der hohe Bekanntheitsgrad und die geradezu monumentale Größe des bereits vorhandenen Datenbestands von Wikidata machen es zu einem idealen Kandidaten für einen zentralen Datenhub geolinguistischer Projekte und Datensammlungen.
Wikidata ist im Kern eine umfangreiche Sammlung strukturierter Daten, die auch zahlreiche sprachwissenschaftliche Konzepte und Kategorien umfasst. De facto stellt Wikidata eine Art universeller Ontologie dar: ein semantisches Netzwerk, das einen außerordentlich großen Bestand an Konzepten und deren Beziehungen untereinander beschreibt und über das Internet zugänglich macht.
Wikidata ist kostenfrei uneingeschränkt verfügbar und weithin bekannt. Die strukturierten Daten von Wikidata stehen unter einer offenen Lizenz (Creative Commons CC0 1.0 Universal) und werden von einer offenen Community gepflegt.2 Grundsätzlich kann sich jede/r an der Entwicklung und Gestaltung von Wikidata beteiligen. Voraussetzung ist lediglich ein, kostenfreier, persönlicher Wikidata-Account.
Wikidata gliedert sich im Wesentlichen in drei Teile:
- die sog. Wikidata-items, eine Sammlung von mit IDs versehenen identifizierbaren Wissenseinheiten. Dabei kann es sich sowohl um abstrakte Konzepte als auch um individuelle Entitäten wie Personen, Orte oder Werke handeln.
- die Wikidata-Lexeme, im Grunde ein multilinguales Wörterbuch
- die Wikidata-Properties, mit denen Eigenschaften und Beziehungen zwischen Dateneinheiten beschrieben werden.
Sämtliche Dateneinheiten von Wikidata verfügen über persistente Identifikatoren und sind über URLs adressierbar.3 Durch Kombination der Identifikatoren lassen sich logische Verbindungen zwischen den einzelnen Dateneinheiten herstellen. Die Verbindungen der Dateneinheiten werden durch die Wikidata-"Properties" hergestellt. Diese stellen selbst eigene Dateneinheiten dar und bestimmen auch die Art der Verbindung zwischen Dateneinheiten. Ein einfaches Beispiel mag dies verdeutlichen:
Das deutsche Lexem Kuh besitzt den Wikidata-Identifikator L34706 und ist über die URL https://www.wikidata.org/wiki/Lexeme:L34706 ansprechbar.
Das italienische Lexem mucca besitzt den Wikidata-Identifikator L641888 und ist entsprechend über die URL https://www.wikidata.org/wiki/Lexeme:L641888 ansprechbar.
Im lexikalischen Kontext repräsentieren Wikidata-Items meistens Konzepte. Das Konzept KUH (WEIBLICHES HAUSRIND NACH DER ERSTEN KALBUNG) besitzt den Wikidata-Identifikator Q11748378 und ist über die URL https://www.wikidata.org/wiki/Q11748378 ansprechbar.
Die Wikidata-Property "item for this sense" schließlich besitzt die ID P5137 und ist über die URL https://www.wikidata.org/wiki/Property:P5137 ansprechbar.
In Wikidata können nun die Lexeme dt. Kuh und it. mucca - mittelbar über den entsprechenden "sense" - unter Verwendung der property "item for this sense" mit dem Konzept KUH verbunden werden. Dies erfolgt entweder formulargestützt über die Adresse der entsprechenden Lexeme (s. DEFAULT) oder über die "quickstatements"‑Schnittstelle von Wikidata (https://quickstatements.toolforge.org/). Letztere erlaubt die Eintragung einer großen Anzahl von Aussagen in kurzer Zeit.
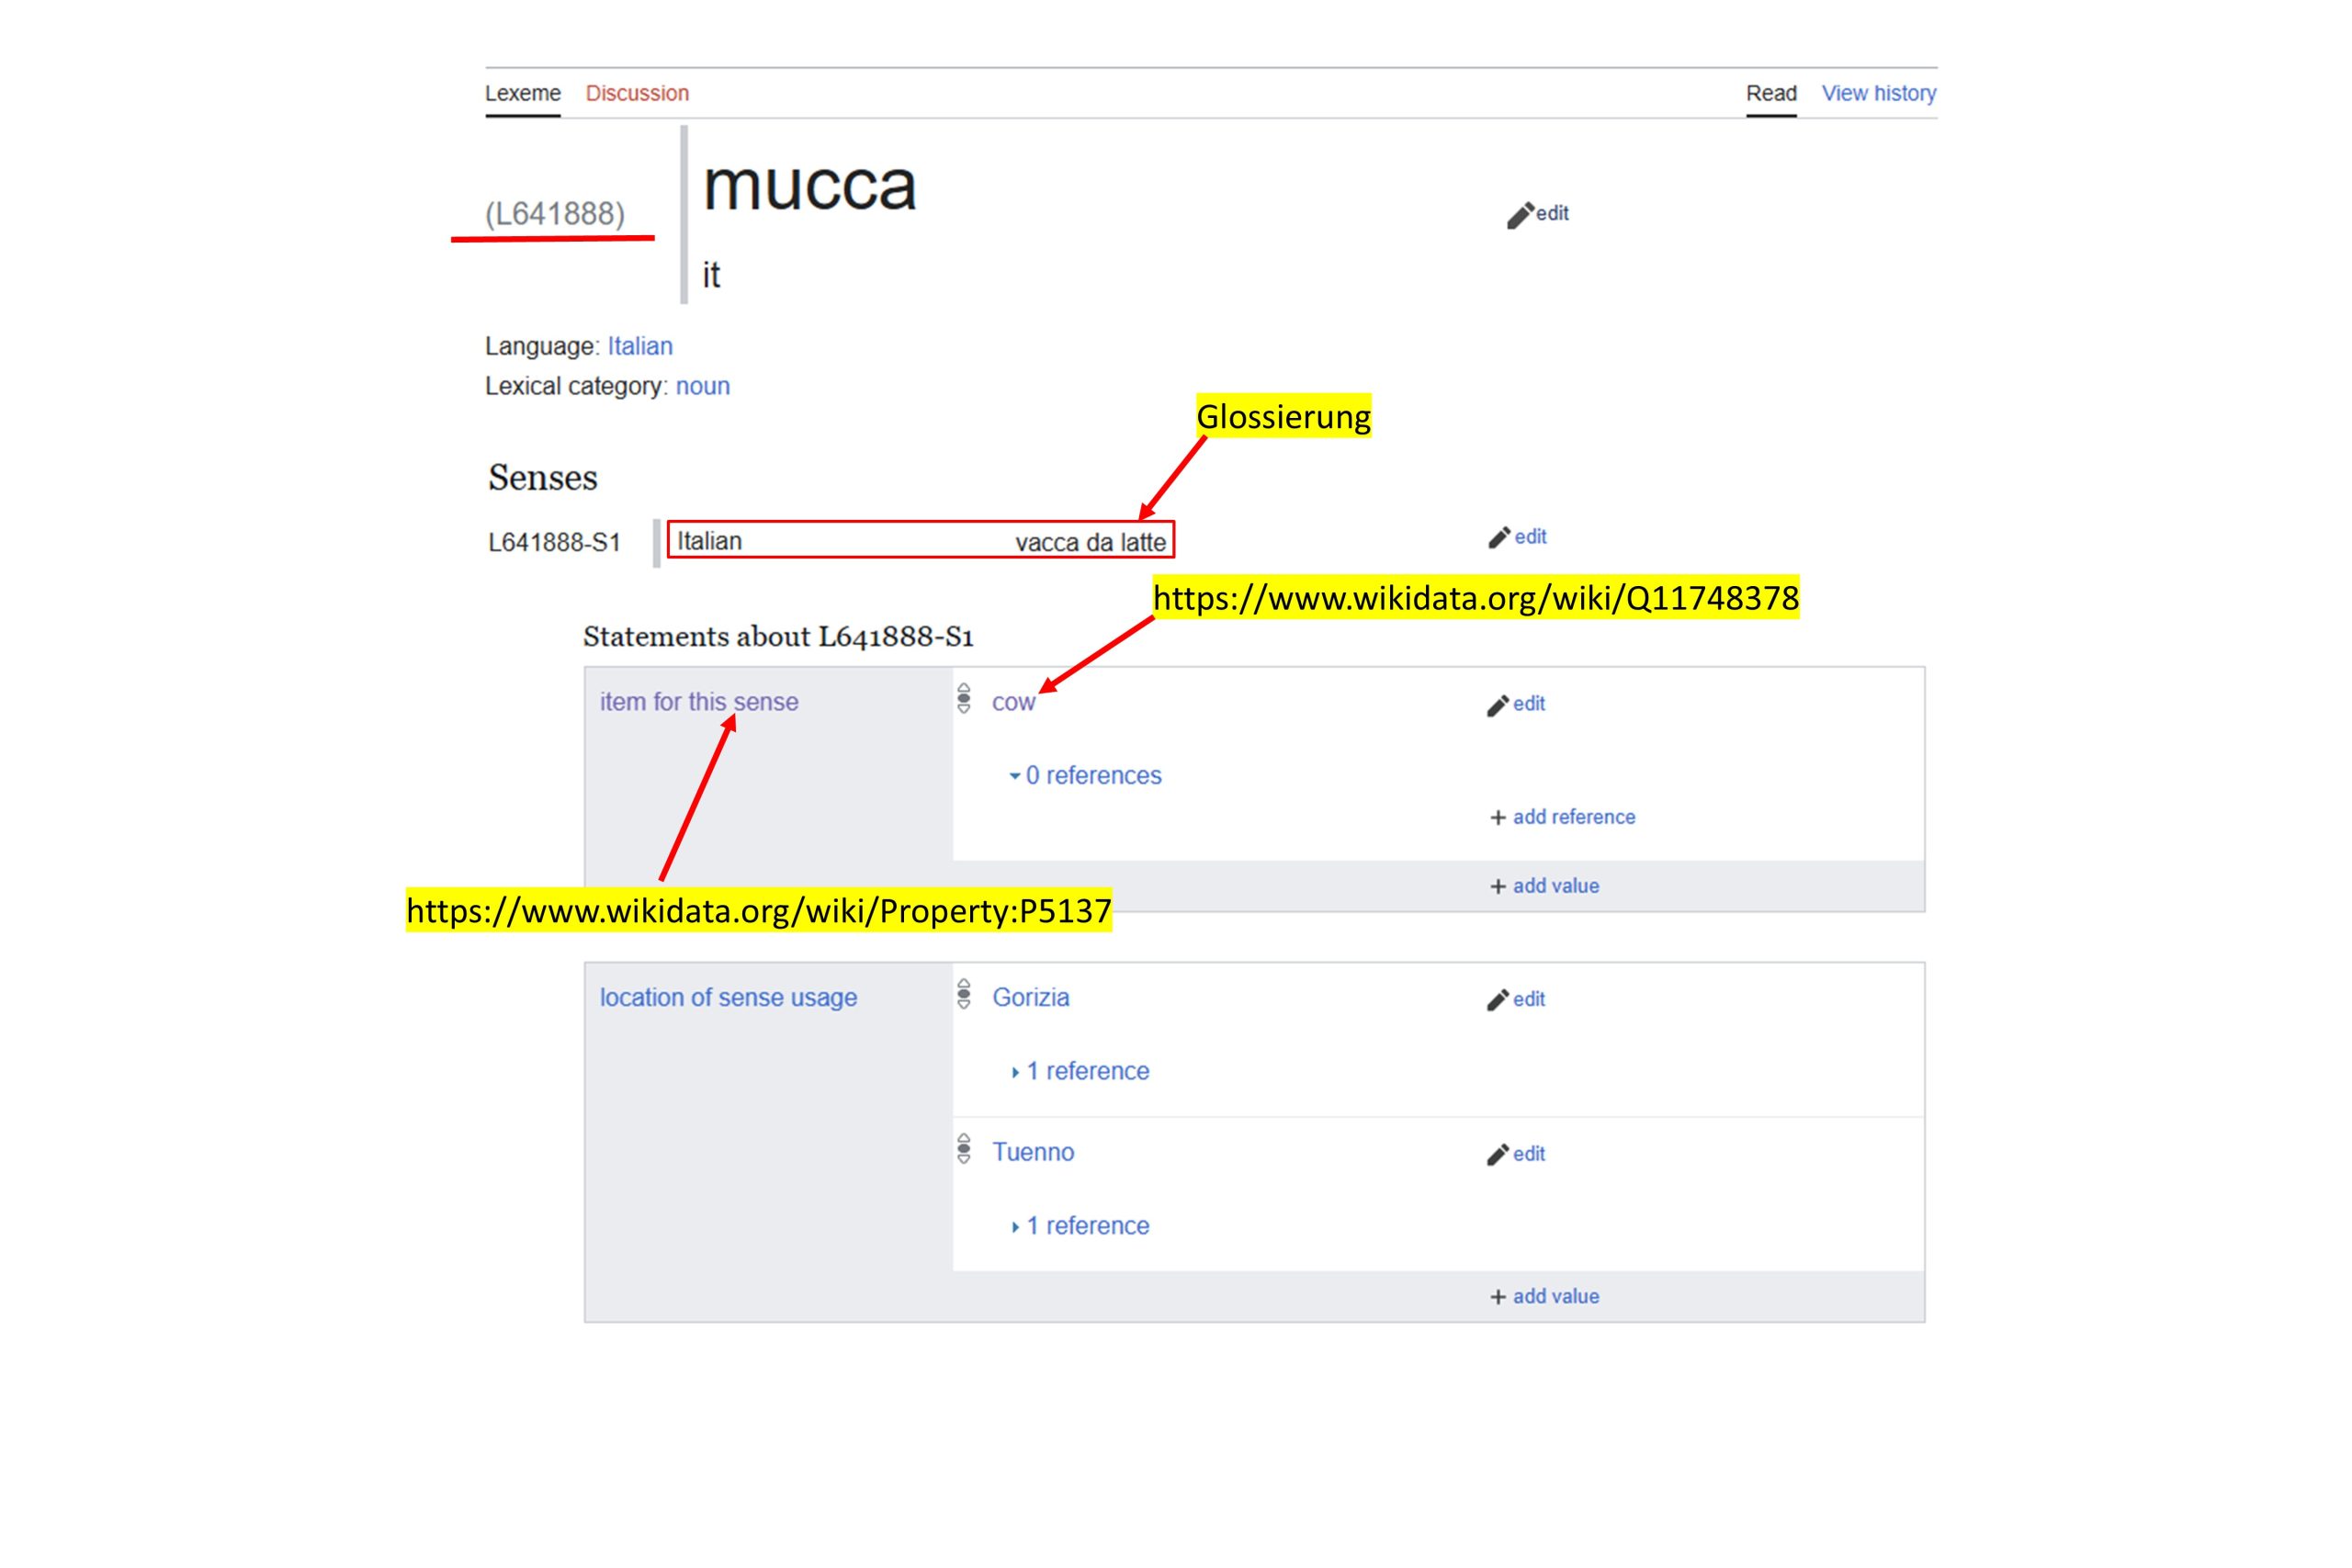
Formular zur Bearbeitung des Lexems mucca in Wikidata (https://www.wikidata.org/wiki/Lexeme:L641888)
Leider ist eine unmittelbare Verknüpfung von Lexemen mit Items nicht möglich. Als Zwischenglied ist ein sog. "sense" erforderlich, der einem Lexem zunächst zugewiesen werden muss. Eine Schwäche des Wikidata-Datenmodells besteht darin, dass zwar jeder Sense einen eindeutigen Identifikator besitzt,4 seine Bedeutung jedoch zunächst nur durch frei formulierte, nicht selbst identifizierte Glossierungen beschrieben wird. Dabei gewährleistet das Datenmodell nicht die semantische Qualität dieser Glossierungen. Als Glossierung kann technisch grundsätzlich jeder nicht leere, mit einem Sprachcode versehene String eingetragen werden, beispielsweise "xyz" oder "1". Ob dieser String die Bedeutung des Sense angemessen beschreibt, kann nur durch redaktionelle Kontrolle sichergestellt werden. Das Problem wird dadurch verschärft, dass die Zuordnung zu einer sprachunabhängigen, durch eine Q-ID identifizierten Bedeutungseinheit über die Property item for this sense (P5137) nicht obligatorisch ist. Rein theoretisch wäre es also möglich, dem deutschen Lexem Kuh einen "sense" mit der deutschen Glossierung "xyz" zuzuweisen und auf die Verknüpfung mit dem item Q11748378 (KUH) zu verzichten. Das Fehlen eines passenden Items stellt hingegen keine prinzipielle Grenze des Datenmodells dar: Sofern das betreffende Konzept die Wikidata-Kriterien erfüllt, kann ein neues Item angelegt werden.
Wikidata verfügt über eine Abfrageschnittstelle, über die der Datenbestand abgefragt und die Ergebnisse in verschiedenen Formaten exportiert werden können (https://query.wikidata.org/). Als Abfragesprache wird SPARQL verwendet, eine Sprache, die speziell für die Abfrage von Daten entwickelt wurde, die im RDF-Modell repräsentiert sind. Dieses Modell wird unter anderem vom Wikidata Query Service verwendet. Die nachfolgende SPARQL-Abfrage liefert eine Übersicht über alle in Wikidata erfassten Lexeme, deren Sense über die Property item for this sense mit dem Konzept KUH verknüpft ist:
SPARQL-Abfrage anzeigen
PREFIX wd: <http://www.wikidata.org/entity/>
PREFIX wdt: <http://www.wikidata.org/prop/direct/>
PREFIX wikibase: <http://wikiba.se/ontology#>
PREFIX ontolex: <http://www.w3.org/ns/lemon/ontolex#>
PREFIX dct: <http://purl.org/dc/terms/>
PREFIX skos: <http://www.w3.org/2004/02/skos/core#>
PREFIX bd: <http://www.bigdata.com/rdf#>

SELECT DISTINCT
  ?lexeme
  ?lemma
  ?language
  ?languageLabel
  ?sense
  ?gloss
WHERE {
  ?lexeme
    dct:language ?language ;
    wikibase:lemma ?lemma ;
    ontolex:sense ?sense .

  ?sense wdt:P5137 wd:Q11748378 .

  OPTIONAL {
    ?sense skos:definition ?gloss .
    FILTER(LANG(?gloss) = LANG(?lemma))
  }

  SERVICE wikibase:label {
    bd:serviceParam wikibase:language "de,it,en" .
  }
}
ORDER BY ?languageLabel ?lemmaWie DEFAULT zu entnehmen ist, kann einer bestimmten Bedeutung eines Lexems, über die Property P6084 ("location of sense usage"; https://www.wikidata.org/wiki/Property:P6084) auch eine Georeferenz zugewiesen werden.
Wikidata deckt ferner zahlreiche sprachwissenschaftliche Kategorien ab. So besitzen etwa „Imperativ“, „Singular“, „Klitikum“, „Dativ“ und „Akkusativ“ eigene Identifikatoren. Auch syntaktische Funktionen wie „direktes Objekt“ und „indirektes Objekt“ werden durch Wikidata-Items repräsentiert. Das orthographische Wort dammelo lässt sich unter Rückgriff auf solche Kategorien folgendermaßen analysieren:
| grammatisches Wort | nächste Wikidata-Entsprechung | Annotation |
|---|---|---|
| da- | L1213314-F43 (dai) | Imperativ (Q22716) + Singular (Q110786) |
| -mme- | L21271-F3 (mi) | Klitikum (Q213458) [+ indirektes Objekt (Q117795513)] |
| -lo | L643345-F8 | Akkusativ (Q146078) + Klitikum (Q213458) [+ direktes Objekt (Q2990574)] |
Die angegebenen Wikidata-Formen entsprechen den segmentierten grammatischen Wörtern nicht in jedem Fall vollständig. So ist da- in dammelo eine gekürzte Form des Imperativs dai; auch -mme- wird in Wikidata nur näherungsweise durch die schwache Form mi repräsentiert.
Durch die Verwendung gemeinsamer, über Wikidata-IDs referenzierter Kategorien können Annotationen verschiedener Sprachen und Projekte auf abstrakter Ebene miteinander verglichen werden. Dabei werden sowohl funktionale Übereinstimmungen als auch strukturelle Unterschiede sichtbar, etwa zwischen klitischen Pronomen im Italienischen und selbstständigen Pronomen im Deutschen.
| Grammatisches Wort | Wikidata-ID | Annotation |
|---|---|---|
| gib | L248794-F26 | Imperativ (Q22716) + Singular (Q110786) |
| es | L248776-F2 | Akkusativ (Q146078) [+ direct object (Q2990574)] |
| mir | L7877-F3 | Dativ (Q145599) [+ indirect object (Q117795513)] |
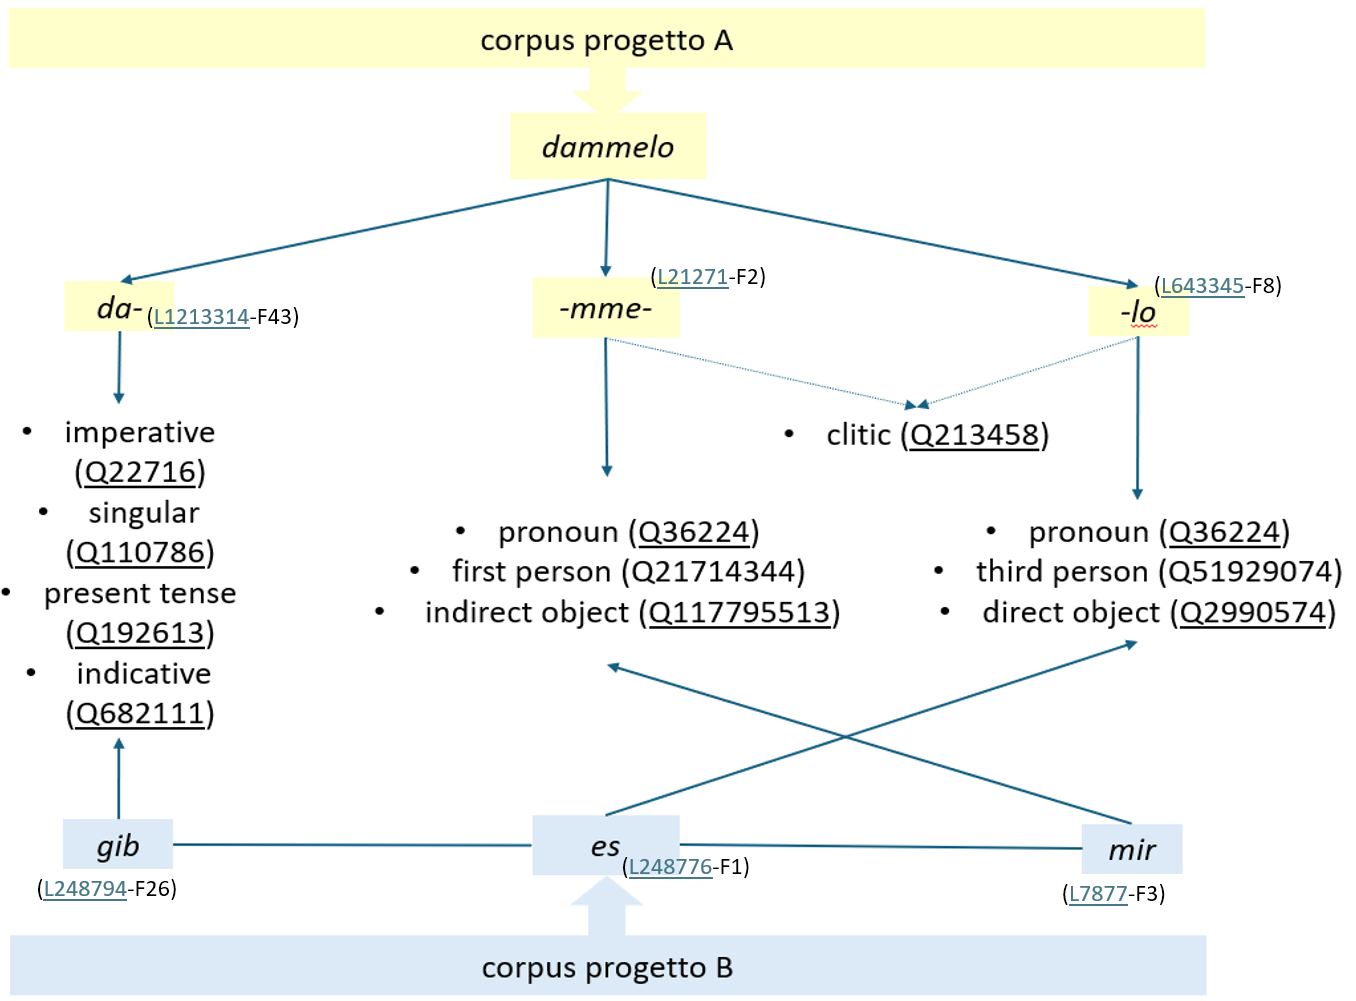
Daten aus zwei Projekten mit einer gemeinsamen kategorialen Referenzebene, abgebildet in Wikidata
Das lexikographische Datenmodell von Wikidata beschreibt dabei jedoch lediglich Lexeme und deren Formen sowie grammatische Merkmale. Die konkrete syntaktische Funktion einer Form, etwa als direktes oder indirektes Objekt, ergibt sich erst aus dem Kontext des jeweiligen Korpusbelegs und kann daher nicht ohne Weiteres der Lexemform selbst zugewiesen werden. Diese Einschränkung schließt eine Verknüpfung syntaktischer Informationen mit Wikidata jedoch nicht grundsätzlich aus. Konkrete syntaktische Strukturen können im projektspezifischen Datenbestand aus den IDs der beteiligten grammatischen Wörter gebildet, mit eigenen Identifikatoren versehen und syntaktischen Kategorien beziehungsweise Strukturtypen zugeordnet werden. Die IDs dieser projektspezifischen Typen lassen sich anschließend über eine Wikidata-Property für externe Identifikatoren mit entsprechenden Wikidata-Items verknüpfen. So könnte beispielsweise die projektinterne Kategorie „direktes Objekt“ mit dem Wikidata-Item Q2990574 verbunden werden. Die einzelnen syntaktischen Belege verbleiben dagegen im projektspezifischen Datenbestand.
Ergänzend empfiehlt es sich, die korrespondierenden Wikidata-IDs auch unmittelbar in den projektspezifischen Daten zu hinterlegen. Je nach Art der betreffenden Einheit können dies Q-IDs von Konzepten, grammatischen Kategorien oder Orten sowie L-IDs von Lexemen sein. Auf diese Weise entsteht eine wechselseitige Verknüpfung: Wikidata verweist über externe Identifikatoren auf die projektseitig definierten Typen, während der Projektdatenbestand seinerseits auf die entsprechenden Wikidata-Entitäten verweist. Dies erleichtert nicht nur den Datenaustausch und projektübergreifende Abfragen, sondern kann auch die Auffindbarkeit der Projektinhalte verbessern. Sofern die betreffenden Projektseiten öffentlich zugänglich und von Suchmaschinen indexierbar sind, können Suchanfragen nach einer Q- oder L-ID auch zu den damit verknüpften Inhalten des Projekts führen.
Das skizzierte Datenmodell von Wikidata eignet sich daher besonders gut für die Verknüpfung lexikographischer Datenbestände. Für die Eintragung der Projekt-IDs in Wikidata ist eine eigene Property erforderlich, die eine ID als Identifikator einer Entität des betreffenden Projekts ausweist. Entsprechende Properties bestehen bereits für eine ganze Reihe lexikographischer Datenbestände:
- Sprachübergreifend: P2581 BabelNet
- Italienisch: P5844 Treccani Vocabulary ID
- Französisch: P11118 Larousse Online French Dictionary ID
- Portugiesisch: P14752 Dicionário da Língua Portuguesa ID
- Spanisch: P12529 Diccionario de la lengua española entry ID
- Rumänisch: P13143 DEX ’09 entry ID
- [VerbaAlpina: P10381]
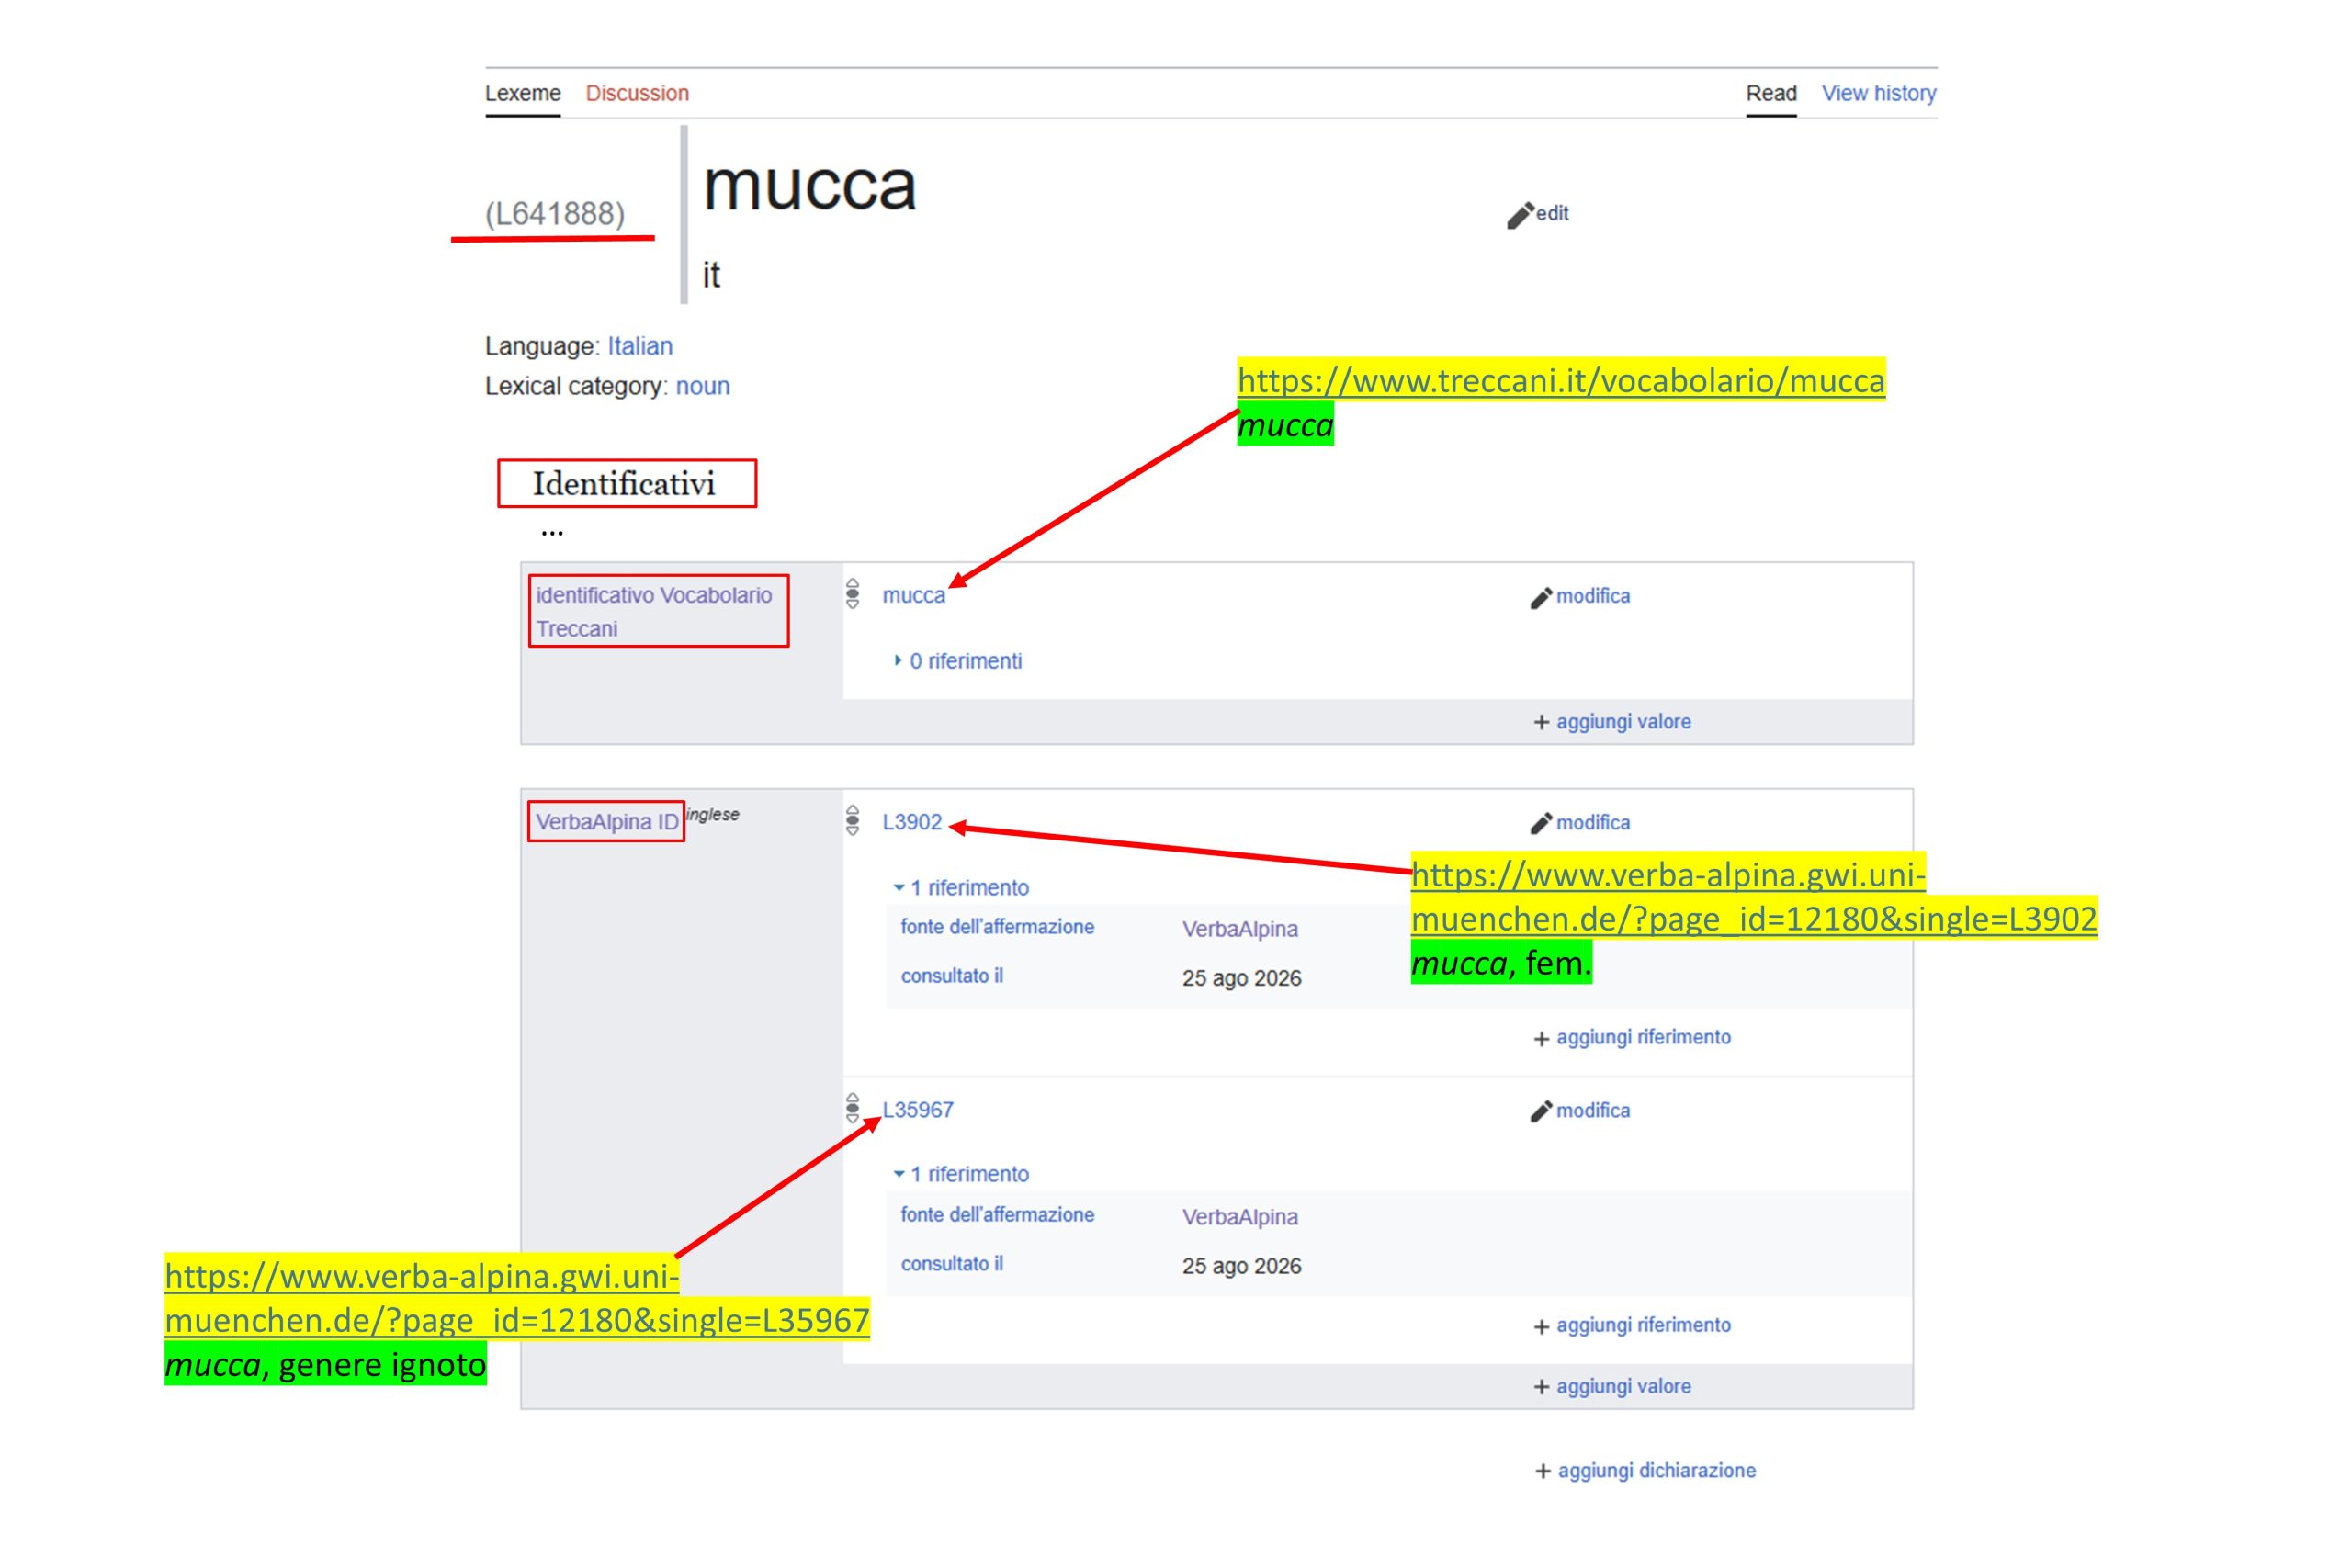
Angabe externer Identifikatoren auf der Wikidata-Page des Lexems L641888 (it. mucca)
Wie bereits erwähnt, erlaubt Wikidata auch die geographische Verortung von lexikalischen Daten - was natürlich gerade im Kontext der Geolinguistik von entscheidender Bedeutung ist. Bei systematischer Eintragung der entsprechenden Informationen lassen sich in Wikidata projektübergreifende Kartierungen lexikalischer Datenbestände realisieren. Als Abfrageschnittstelle dient wiederum der Wikidata Query Service. Hier zeigen wir eine Wikidata-Kartierung der Verbreitung des italienischen Lexems mucca:
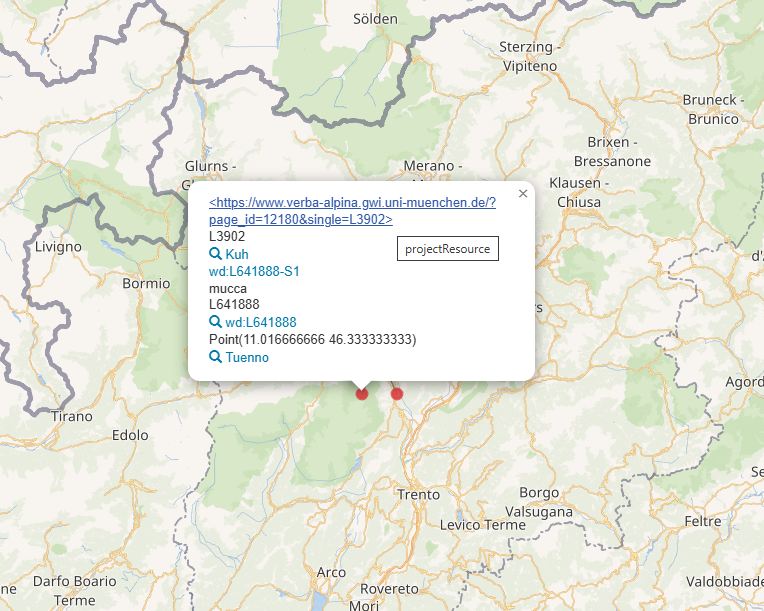
Kartierung der SPARQL-Abfrage nach dem Lemma "mucca"
SPARQL-Abfrage anzeigen
#defaultView:Map
# defaultView:Table

PREFIX wd:       <http://www.wikidata.org/entity/>
PREFIX wdt:      <http://www.wikidata.org/prop/direct/>
PREFIX wikibase: <http://wikiba.se/ontology#>
PREFIX ontolex:  <http://www.w3.org/ns/lemon/ontolex#>
PREFIX dct:      <http://purl.org/dc/terms/>
PREFIX bd:       <http://www.bigdata.com/rdf#>
PREFIX rdfs:     <http://www.w3.org/2000/01/rdf-schema#>

SELECT DISTINCT
    ?place
    (str(?placeLabel) as ?luogo)
    ?coord
    (?lexemeID as ?WikidataID)
    ?lemma
    ?sense
    (?item as ?QID)
    (ucase(str(?itemLabel)) as ?concetto)
    (?identifier as ?projectIdentifier)
    ?projectResource
WHERE {

    # Italienisches Lexem "mucca"
    ?lexeme
        dct:language wd:Q652 ;
        wikibase:lemma ?lemma ;
        ontolex:sense ?sense .

    FILTER(STR(?lemma) = "mucca")

    BIND(
        REPLACE(
            STR(?lexeme),
            "http://www.wikidata.org/entity/",
            ""
        )
        AS ?lexemeID
    )

    # Geographische Verwendung des jeweiligen Sense
    ?sense wdt:P6084 ?place .

    # Koordinaten für die Karte
    ?place wdt:P625 ?coord .

    # Mit dem Sense verbundenes Wikidata-Konzept
    OPTIONAL {
        ?sense wdt:P5137 ?item .
    }

    # Externe Identifikatoren am Lexem
    OPTIONAL {
        ?identifierProperty
            wikibase:propertyType wikibase:ExternalId ;
            wikibase:directClaim ?identifierPredicate ;
            wdt:P1630 ?formatterURL .

        ?lexeme ?identifierPredicate ?identifier .

        BIND(
            IRI(
                REPLACE(
                    STR(?formatterURL),
                    "\\$1",
                    ENCODE_FOR_URI(STR(?identifier))
                )
            )
            AS ?projectResource
        )
    }

    SERVICE wikibase:label {
        bd:serviceParam wikibase:language "de,it,en".
        ?item rdfs:label ?itemLabel .
        ?place rdfs:label ?placeLabel .
    }
}
ORDER BY
    ?placeLabel
    ?identifier
Das dünne Belegnetz erklärt sich durch die bislang nur spärliche Eintragung entsprechender Georeferenzen in Wikidata.
4.2.2. Grenzen von Wikidata
Aus der Perspektive der Geolinguistik weist Wikidata auch Grenzen auf. So ist sein lexikographisches Datenmodell nicht auf die Aufnahme vollständiger Textkorpora ausgelegt. Es folgt vielmehr dem Paradigma des Wörterbuchs und orientiert sich entsprechend an Lexemen sowie deren Formen und Bedeutungen.
Auch bei lexikographischen Datenbeständen, die grundsätzlich gut mit dem Datenmodell von Wikidata-Lexemes kompatibel sind, können Inkongruenzen zwischen der projektspezifischen Struktur und dem Wikidata-Datenmodell auftreten. Als Beispiel kann VerbaAlpina genannt werden: Das Projekt vereinigt die italienischen und französischen Lexeme monte und mont zu dem romanischen Lexemtyp mont/monte. In Wikidata werden monte und mont hingegen als zwei getrennte, jeweils einer Einzelsprache zugeordnete Lexeme modelliert. Die Lösung besteht in diesem Fall darin, denselben projektspezifischen Lexemtyp beiden Wikidata-Lexemen zuzuordnen.
Auch andere projektspezifische Differenzierungen lassen sich nur eingeschränkt abbilden, etwa wenn ein Lexem regional unterschiedliche Genera besitzt. Zwar kann das grammatische Genus technisch auch einem Sense zugewiesen und dieser mit einem geographischen Verwendungsgebiet verbunden werden. Die Nutzungshinweise zu P5185 empfehlen jedoch, das Genus unmittelbar am Lexem anzugeben. Für die Verknüpfung eines bestimmten Genus mit einer bestimmten lokalen Verwendung besteht daher kein eindeutig etabliertes Modell. Die Darstellung auf der Ebene des Sense kann zudem den missverständlichen Eindruck erwecken, das Genus sei eine Eigenschaft der Bedeutung oder des über P5137 verbundenen Konzepts, obwohl es sich um eine Eigenschaft des sprachlichen Ausdrucks handelt.
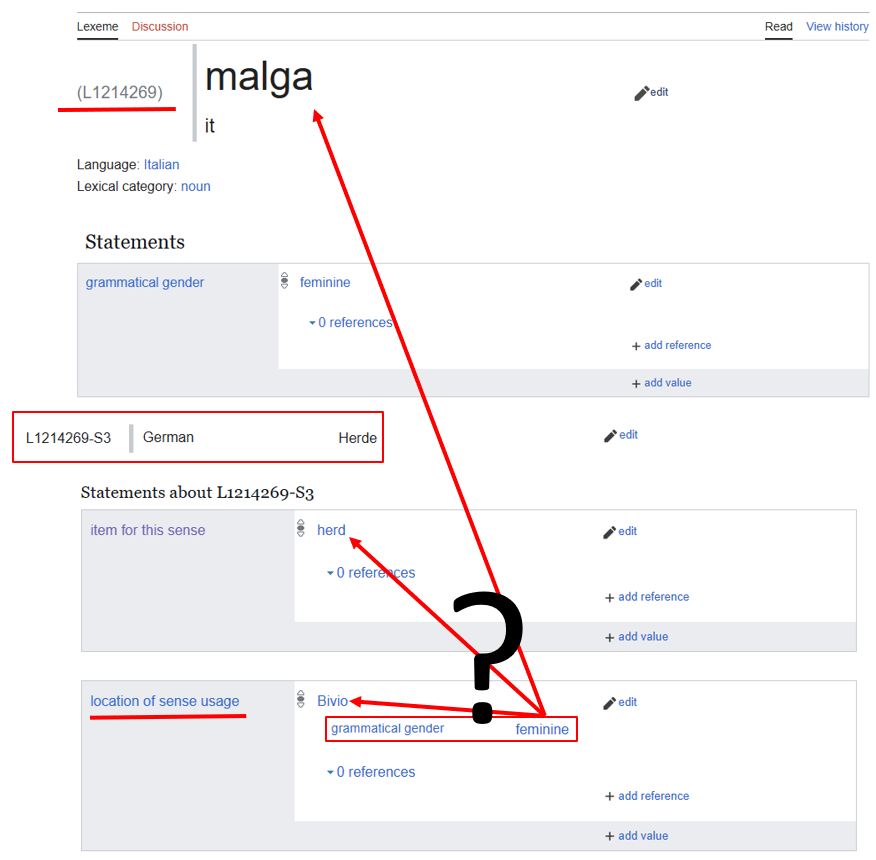
Wikidata-Seite des Lexems malga (L1214269). Die Abbildung der Aussage, dass das Wort malga im Ort Bivio im Feminin verwendet wird, führt zu missverständlichen Ergebnissen.
Wikidata eignet sich auch nur eingeschränkt für die Annotation konkreter phonetischer oder syntaktischer Strukturen. Zwar sind zahlreiche phonetische, morphologische und syntaktische Kategorien als Wikidata-Items vorhanden. Es fehlt jedoch ein Datenmodell, mit dem sich konkrete Korpusstrukturen aus geordneten und gruppierten IDs grammatischer Wörter abbilden ließen. Entsprechendes gilt für konkrete phonetische Realisierungen und ihre Zuordnung zu einzelnen Korpusbelegen oder Abschnitten einer Tonaufnahme. Dies hängt damit zusammen, dass Wikidata nicht für die Aufnahme vollständiger Textkorpora und ihrer einzelnen Wörter ausgelegt ist.
Die konkreten Annotationen müssen daher im projektspezifischen Datenbestand verbleiben. Syntaktische Einheiten können dort, wie oben gezeigt, aus den IDs der beteiligten Wörter gebildet und bestimmten Strukturtypen zugeordnet werden. Analog dazu lassen sich phonetische Realisierungen mit einzelnen Korpusbelegen oder zeitlich definierten Abschnitten einer Tonaufnahme verbinden und phonetischen Typen zuordnen. Die projektseitig definierten syntaktischen und phonetischen Typen können mit persistenten IDs versehen und, soweit entsprechende Kategorien vorhanden sind, mit Wikidata-Items verknüpft werden. Wikidata nimmt dann nicht die einzelnen Annotationen auf, sondern dient als gemeinsamer Referenzpunkt für deren Typisierung.
Grundsätzlich sind Erweiterungen und sogar Änderungen des Wikidata-Datenmodells durchaus machbar. Allerdings ist dies in aller Regel mit einem mehr oder weniger aufwendigen Diskurs mit der Wikidata-Community verbunden. Eine vollkommen freie Gestaltungsmöglichkeit ist in diesem Zusammenhang nicht gegeben.
Ganz grundsätzlich ist festzuhalten, dass nicht sämtliche vorstellbaren Datenmodelle sprachwissenschaftlicher Projekte vollständig auf das Datenmodell von Wikidata abgebildet werden können. Wikidata kann aber eine gemeinsame Identifikations- und Verknüpfungsschicht über den einzelnen Forschungsdatenbeständen bilden.
Eine Anbindung setzt nicht die Übernahme der gesamten projektspezifischen Struktur in Wikidata voraus. Entscheidend ist vielmehr die Identifikation geeigneter Verknüpfungsebenen. Dazu müssen die Einzelbelege im projektspezifischen Datenbestand sinnvoll aggregiert beziehungsweise typisiert und die daraus entstehenden Einheiten mit stabilen Identifikatoren versehen werden. Diese Typen können anschließend mit passenden Wikidata-Entitäten – etwa Konzepten, Lexemen, Sprachen oder Orten – verknüpft werden. Die feingranularen Einzelbelege und ihre projektspezifischen Annotationen verbleiben dagegen im jeweiligen Forschungsdatenbestand.
Weitere Nachteile ergeben sich aus der gemeinschaftlichen Organisation von Wikidata und der begrenzten Kontrolle über einmal eingetragene Daten. Wikidata wird technisch von der Wikimedia Foundation betrieben, während die inhaltliche Pflege und wesentliche Entscheidungen von der Wikidata-Community getragen werden. Änderungen oder Löschungen eigener Einträge können daher ebenso wenig ausgeschlossen werden wie fehlerhafte Bearbeitungen durch Dritte.
Die genannten Nachteile sprechen jedoch nicht gegen eine Nutzung von Wikidata. Vielmehr erscheint es sinnvoll, Projektdaten so weit mit Wikidata zu verknüpfen, wie es dessen bestehende Strukturen zulassen. Zugleich liefern die skizzierten Defizite ein weiteres Argument für den Aufbau eines spezialisierten zentralen Systems, das die bislang disparaten Projektdaten integriert. Auch nach der Etablierung eines solchen Systems würde die Einbindung von Wikidata keineswegs überflüssig. Wikidata könnte das zentrale System vielmehr ergänzen, es mit weiteren Wissensbeständen vernetzen und damit dauerhaft eine wichtige Funktion erfüllen.
Bibliographie
- ADDU = Thun, Harald / Elizaincín, Adolfo (2000-): Atlas lingüístico diatópico y diastrático del Uruguay, Kiel, Westensee.
- AISr = Loporcaro, Michele / Schmid, Stephan / Pescarini, Diego / Tisato, Graziano / Donzelli, Giulia / Negrinelli, Stefano / Zanini, Chiara (2019): AIS, reloaded (AISr), Zurich, University of Zurich, University of Zurich (Link).
- ALD = Goebl, Hans / Bauer, Roland / Haimerl, Edgar (Hrsgg.) (1998-2002): (ALD) Atlant linguistich dl ladin dolomitich y di dialec vejins. Atlante linguistico del ladino dolomitico e dei dialetti limitrofi. Sprachatlas des Dolomitenladinischen und angrenzender Dialekte, vol. Part I: 4 voll., Wiesbaden, Reichert [3 CD-ROMs, 1 DVD] (Link).
- ALDC 1998 = ALDC (1998): Atles Lingüístic del Domini Català (Link).
- ALF = Gilliéron, Jules / Edmont, Edmond (Hrsgg.) (1902-1910): Atlas linguistique de la France (ALF), vol. 10 vol., Paris, Champion [Reprint: Bologna: Forni 1968] (Link).
- ALGR = Thun, Harald / Dietrich, Wolf / Aquino, Almidio / Symeonidis, Haralambos (Hrsgg.) (2009-): Atlas Lingüístico Guaraní-Románico. Tomo 1: Léxico del cuerpo humano, Kiel, Westensee, Westfälische Wilhelms-Universität Münster/Christian-Albrechts-Universität Kiel.
- ALI = Bartoli, Matteo (1995-): Atlante linguistico italiano, a cura di U. Pellis & L. Massobrio, vol. 7, Roma, Istituto Poligrafico e Zecca dello Stato (Link).
- ALiB 2014- = ALiB (2014-): Atlas Linguístico do Brasil, Londrina.
- ALPA = Le Dû, Jean / Brun-Trigaud, Guylaine (Hrsgg.) (2011-2013): Atlas Linguistique des Petites Antilles, 2 Vol., Paris, CTHS.
- ALPI-CSIC = García Mouton, Pilar / Fernández-Ordóñez, Inés / Heap, David / Perea, Maria Pilar / Saramago, João / Sousa, Xulio (Hrsgg.) (2016): El Atlas Lingüístico de la Peninsula Ibérica de Tomás Navarro Tomás (Link).
- ALS = Ruffino, Giovanni (Hrsg.) (1991-): Atlante linguistico della Sicilia, Palermo, Centro di studi filologici e linguistici siciliani.
- APV/1 = Favre, Saverio / Raimondi, Gianmario (Hrsgg.) (2020): Atlas des patois valdôtains - Le lait et les activités laitières, vol. 1, Arvier, Le Château.
- AsiCa2 = Englmeier, Tobias / Gacia, Veronika / Krefeld, Thomas / Lücke, Stephan (2019): Atlante sintattico della Calabria rielaborato (Asica2), München, LMU (Link).
- AsiCa2.0 = Krefeld, Thomas / Lücke, Stephan (Hrsgg.) (2019): Atlante sintattico della Calabria. Rielaborato tecnicamenta da Veronika Gacia e Tobias Englmeier, München, online, LMU (Link).
- Avolio/De Gasperis/Giammaria 2020 = Avolio, F. / De Gasperis, G. / Giammaria, T. (2020): L’Atlante Linguistico ed Etnografico Informatizzato della Conca Aquilana (ALEICA): presentazione della versione definitiva, in: Romance philology, vol. 27, 2, 267-287.
- BabelNet = Navigli, Roberto (Hrsg.): BabelNet (Link).
- Colcuc in Vorbereitung = Colcuc, Beatrice (in Vorbereitung): Confini nel continuum? Percezione e rappresentazione della variazione linguistica nelle Dolomiti, München, LMU.
- DigitALIa 2022 = DigitALIa (2022): Digitalisation of Italian Linguistic Atlases (Link).
- DRG = Melcher, Florian / De Planta, Robert (Hrsgg.) (1939-): Dicziunari Rumantsch Grischun, Cuoira, Società Retorumantscha (Link).
- Krefeld 2002a = Krefeld, Thomas (2002): Migration, Sprachbewusstsein und Wissenschaftsideologie - über dynamische Räume und ihre statische Beschreibung. Download (PDF, ca. 9,1 MB), in: Schubert/Ehlich 2002, 145-170 (Link).
- Krefeld 2024a = Krefeld, Thomas (2024): Romània migratoria, in: Korpus im Text, Serie A, 107182, München, LMU (Link).
- Krefeld 2025c = Krefeld, Thomas (2025): I’m beginning to see the light: Die Perspektive einer virtuellen romanischen Geolinguistik, in: Korpus im Text, Serie A, vol. 128906, München, LMU (Link).
- Krefeld/Lücke 2014-2023 = Krefeld, Thomas / Lücke, Stephan (Hrsgg.) (2014-2023): VerbaAlpina. Der alpine Kulturraum im Spiegel seiner Mehrsprachigkeit, München, online, LMU (Link).
- Krefeld/Lücke 2023 = Krefeld, Thomas / Lücke, Stephan (2023): Sketching out a Virtual Framework for Romance Geolinguistics,, in: Weiland / Quijada van den Berghe / Pustka (2023).
- Krefeld/Lücke 2023a = Krefeld, Thomas / Lücke, Stephan (2023): FAIRNESS – Medien im methodologischen Zentrum der Geolinguistik, in: Krefeld/Lücke/Mutter 2023, München (Link).
- Thesoc = Oliviéri, Michèle / Dalbera, Jean-Philippe (Hrsgg.): Base de données lexicales, Nice (Link).
- Treccani = Treccani: Treccani Vocabolario online [[letzter Zugriff am 30.09.2020]] (Link).
- VIVALDI = Kattenbusch, Dieter (Hrsg.) (1998-2016): Vivaio Acustico delle Lingue e dei Dialetti d'Italia, Berlin, Humboldt-Universität [Ultimo accesso 12/01/2019 ore 10:34] (Link).