1. Motivation
- Wörterbücher sind unverzichtbar (für alle wiss. Disziplinen, darüber hinaus auch außerhalb der Wissenschaft)
- Online-Lexika sind ein Grundstein (nicht nur) der Digital Humanities (DH), da grundlegend für einzelsprachunabhängige bzw. -übergreifende Konzeptverknüpfungen (vgl. Krefeld 2020; vgl. z. B. Suchen nach wissenschaftlichen Arbeiten zu Milch/lait/latte/milk/...)
- Villa Vigoni-Thesen fordern grundlegende Neugestaltung der Lexikographie (lexikalische Informationssysteme als Wörterbücher der Zukunft)
- Die Bedeutung lexikographischer Daten wird auch unterstrichen durch die Existenz einer eigenen Rubrik in Wikidata (Identifizierung der Lexeme durch sog. L-IDs)
- Die Verknüpfung vorhandener Wörterbuchressourcen ist wünschenswert und durch Digitalisierung/Strukturierung möglich
- Maximaler Nutzen entfaltet die Verknüpfung erst durch konsequente und selektive, gleichzeitig aber konsistente Tiefenstrukturierung der Wörterbuchinhalte
2. State of the art
- Bestehende Wörterbuchressourcen sind bislang höchstens teilstrukturiert
- Im äußersten Fall (auch bei Präsentation der jeweiligen Wörterbuchartikel/-einträge) reicht die Strukturierung nur bis auf die Ebene der Lemmata - die dann bestenfalls über lemmagenaue URLs (lgU) referenziert werden können -, aber nicht in die Artikel hinein.
- Bei den Einträgen zu den einzelnen Lemmata handelt es sich in den meisten Fällen um nicht strukturierte Fließtexte.
- Diese Wörterbucheinträge enthalten in unstrukturierter Form lexikographisch hochrelevante Informationen, die erst durch konsequente Strukturierung adressierbar und im Sinne der FAIR-Kriterien interoperabel gemacht werden können.
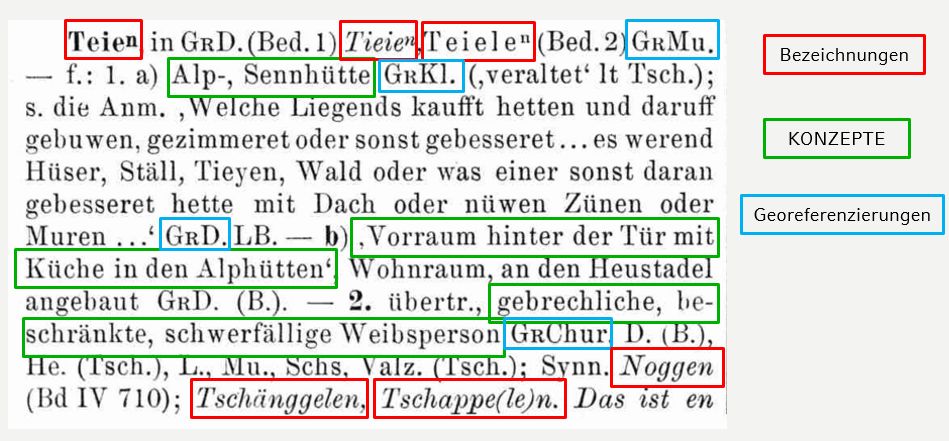
- Zur Illustration ein Eintrag aus dem Idiotikon, s. v. Teie(n). Verschiedene Bezeichnungsvarianten sowie regional unterschiedliche Bedeutungen (= Konzepte) sind ohne entsprechende Kategorisierung (= unstrukturiert) über den Fließtext verteilt:
- Es könnten zahlreiche weitere Beispiele aus der unten gegebenen Wörterbuchliste gegeben werden (zur Erläuterung der Problematik s. auch Krefeld/Lücke 2020a, Par. 2.2 [https://www.verba-alpina.gwi.uni-muenchen.de/?p=9258])
- Die Mängel der Einzelwörterbücher können auch bestehende wörterbuchübergreifende Metasuchmaschinen wie etwa woerterbuchnetz.de (logischerweise) nicht wett machen.
- Manche vorhandenen lexikographischen Ressourcen wiederum (z. B. BabelNet) bieten keine unmittelbare Referenzierung (Verlinkung) auf vorhandene Lexika (dadurch bleibt das Niveau der gedruckten Lexikogpahie verborgen)
3. Ziel
- Pluridimensionale Verknüpfung der Inhalte ausgewählter, qualitativ hochwertiger Wörterbücher durch Abbildung von auch und gerade in den Wörterbucheinträgen enthaltenen lexikographisch relevanten Informationen
- Einrichtung eines skalierbaren (spätere Einbindung zusätzlicher Wörterbücher ermöglichenden) und auf Dauer verfügbaren lexikographischen Informationssystems (FAIR compliant) mit Möglichkeit zur Suche nach Wörtern und Wortformen, Konzepten/Begriffen und Etymologien unter Einbeziehung der chronologischen und geographischen Dimension, dabei Anbindung an etablierte Normdatensysteme (GND, Wikidata [Q-IDs *und* L-IDs]), so dass auch Suchen nach Normdaten möglich sind.
- Optional: Abbildung in RDF
4. Umsetzung
4.1. Grundlegendes und Vorarbeiten
- Zentrale Herausforderung: Weitgehend automatisierte strukturierte Erfassung definierter Informationen/Entitäten aus Wörterbuchartikeln und deren Abbildung in einem geeigneten (relationalen?) Datenmodell
- Informatisch-algorithmische Strukturierung der Wörterbuchartikel stößt bei Abschnitten in natürlicher Sprache an ihre Grenzen. Die folgende Grafik zeigt einen Eintrag aus dem REW, die von einem von Florian Zacherl entwickelten Algorithmus strukturiert wurde. Rot markiert natürliche Sprache, alle anderen Farben zeigen strukturierte Daten an:
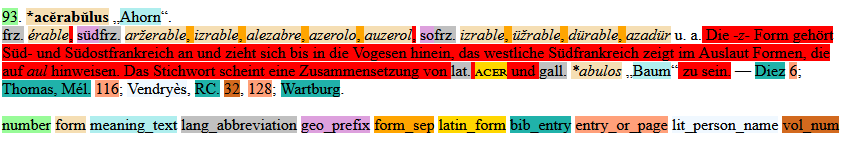
Visualisierung eines REW-Eintrags, der mit Hilfe eines von Florian Zacherl entwickelten Algorithmus strukturiert wurde.
- Folgende zentrale Entitäten sollen aus den bestehenden Wörterbuchressourcen strukturiert extrahiert werden (in Klammern die Attribute der jeweiligen Entitäten; ggf. erweiterbar):
- Lexeme (Sprachzugehörigkeit, Wortart, Genus, Herkunft [Etymon/Basistyp], Georeferenz, Chronoreferenz, Belegreferenz [= Lemmaeinträge in Wörtbüchern])
- Wortformen (Lexem, Casus, Numerus, Genus Verbi, Georeferenz, Chronoreferenz, Belegreferenz)
- Konzepte/Begriffe/Bedeutungen
- Die Einzelinstanzen dieser Entitäten werden untereinander wiederum verknüpft (Zuordnung von Lexemen zu Bedeutungen, Wortformen zu Lexemen ...), wodurch am Ende ein komplexes Beziehungsgeflecht entsteht (z. B. werden die lateinischen Formen im AWB mit den Lemmata/Einträgen im Georges verlinkt, die altgriechischen Formen im Georges mit den Lemmata/Einträgen im Gemoll 1908 und im LSJ usw.)
- Im fertigen lexikalischen Informationssystem ist schließlich ein analytischer Zugang über jede der definierten Entitäten möglich (auch in Kombinationen).
- Einen Eindruck vom am Ende bestehenden Beziehungsgeflecht kann ein sog. Belegfenster des Projekts VerbaAlpina vermitteln:
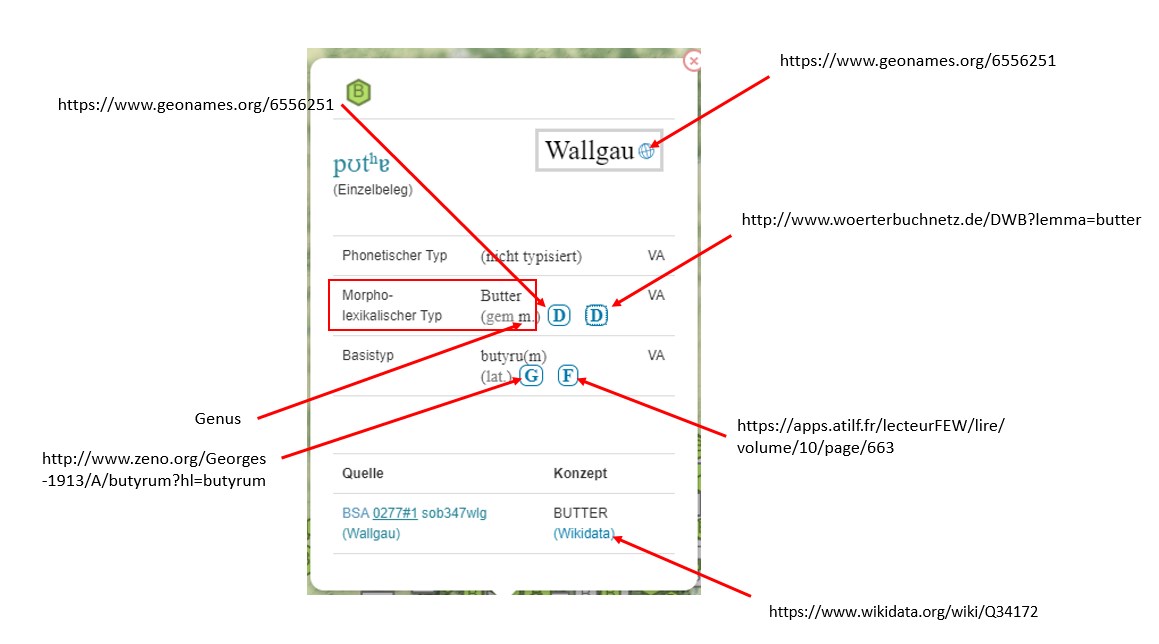
Beziehungsgeflecht des Lexems "Butter" in einem Belegfenster des Projekts VerbaAlpina
4.2. Task 1: Auswahl der Wörterbücher und Einrichtung der Infrastruktur
| T1 |
- Auswahl exemplarischer Wörterbuchressourcen (gemäß Liste unten)
- Dabei Abdeckung zweier wichtiger europäischer Sprachfamilien: Germanisch, Romanisch
- Einbeziehung von Latein und Altgriechisch als wichtigen Referenzpunkten moderner Sprachen (Georges) und ihrer kulturgeschichtlichen Konditionierung
- Voraussetzung: urheberrechtsfrei
- Digitalisierungsstatus der ausgewählten Wörterbücher gemäß http://www.kit.gwi.uni-muenchen.de/?p=40112#p:5 bezogen auf die Adressierbarkeit der einzelnen Lemmata. Keines der Wörterbücher weist eine erweiterte Tiefenstrukturierung im Sinne obiger Skizze auf (aufsteigend: Attribute links der Markierung sind jeweils inkludiert):
| Task | Wörterbuch | D0 | D1 | D2 | D3 | Web | lgU (Lemmagenaue URLs) |
|
| 1 | 2 | REW | x | |||||
| 2 | 3 | Georges | x | |||||
| 3 | 4 | TLFi | x | |||||
| 4 | 4 | AWB | x | |||||
| 5 | 4 | DWDS | x | |||||
| 6 | 4 | LSJ | x | |||||
| 7 | 4 | TLIO | x | |||||
| 8 | 4 | Idiotikon | x* | |||||
| 9 | FEW | x* | ||||||
| 10 | DRG | x | ||||||
| 11 | DOM | x | ||||||
| 12 | Verba Alpina | x | ||||||
| 13 | LEO | x | ||||||
| 14 | Gemoll 1908 | x | ||||||
| 15 | Sottile 2002 | x | x** | |||||
| 16 | Sottile/Genchi 2010 | x | ||||||
| 17 | Foti 2015 | x | ||||||
| 18 | Raccuglia 2003 | x | ||||||
| 19 | Trovato/Lanaia 2011 | x | ||||||
| 20 | LEI | x | ||||||
| 21 | Schmeller | x | ||||||
| 22 | Boerio 1829 | x | ||||||
| 23 | Cherubini 1814 | x | ||||||
| 24 | VS | x | ||||||
| 25 | Pirona u. a. 1935 | x |
\* = nicht exakt referenziert (etwa nur druckseitengenau)
\** = teilweise
- Entwicklung und Aufbau des Web-Portals (URL-Vorschlag: lexicon.ub.uni-muenchen.de)
- Entwicklung der Datenstruktur und Einrichtung der zentralen Datenbank
- Entwicklung von Tools zur Erleichterung der Arbeit der Lexikographie-Experten (initial und projektbegleitend)
4.3. Task 2: Prototypische erweiterte Tiefenstrukturierung des REW (Status D1 [Scan])
| T2 |
- Semiautomatische, algorithmische Tiefenstrukturierung des REW (Nr. 1) basierend auf typographischen Eigenheiten und Abbildung im festgelegten Datenbankschema (weit fortgeschrittene Vorarbeiten von Florian Zacherl)
- Im Zuge dessen: Entwicklung eines parametrisierbaren OCR-Verfahrens inkl. Nachkorrekturen
- Nachgelagert: Klassifizierung/Lemmatisierung und wechselseitige Verknüpfung der aus den Wörterbuchartikeln extrahierten Daten durch die Sprachwissenschaftler
- Anbindung des Datenmaterials an Normdatensysteme durch den Metadatenspezialisten
4.4. Task 3: Skalierung der prototypischen Prozedur auf zunächst ein weiteres Wörterbuch
| T3 |
- Exemplarische Übertragung/Anwendung des prototypischen Verfahrens auf Georges (Nr. 2)
- Verknüpfung der Inhalte des REW mit denen von Georges
4.5. Task 4: Skalierung: Anwendung der Prozedur auf weitere ausgewählte Wörterbücher
| T4 |
- Übertragung/Anpassung des Verfahrens auf weitere Wörterbücher (Florian Zacherl, dessen einschlägige Strukturierungsarbeit am REW bereits weit fortgeschritten ist, schätzt, dass mit dem angepeilten Personaleinsatz [s. u.] innerhalb von 3 Jahr maximal 8 Wörterbücher in der vorgesehenen Weise strukturiert und verknüpft werden können)
- Dabei schrittweises Vorgehen und Ausgewogenheit bezüglich Sprachfamilien und Diachronie:
- Optionale Erweiterungen (sofern zeitlich und personell realisierbar):
- Nr. 9: FEW (Französisch)
- Nr. 10: DRG (Rätoromanisch; bislang nur bis Buchstabe M)
- Nr. 11: DOM (Okzitanisch; Vorstufe Romanisch)
- Nr. 12: Verba Alpina (mehrsprachig)
- Nr. 13: LEO (mehrsprachig)
- Nr. 14: Gemoll 1908 (Altgriechisch)
- Nr. 15: Sottile 2002
- Nr. 16: Sottile/Genchi 2010
- Nr. 17: Foti 2015
- Nr. 18: Raccuglia 2003
- Nr. 19: Trovato/Lanaia 2011
- Nr. 20: LEI
- Nr. 21: Schmeller
- Nr. 22: Boerio 1829
- Nr. 23: Cherubini 1814
- Nr. 24: VS
- Nr. 25: Pirona u. a. 1935
4.6. Verstetigung
- Übernahme und dauerhafter Betrieb des Dienstes durch die UB der LMU
5. Expertise und Personal
- Im Projekt erforderliche Kompetenzen: Lexikographie – DH/Informatik – FDM
- Informatiker für semiautomatische algorithmische Tiefenstrukturierung von Wörterbüchern
- Informatiker für Konzeption und Pflege des zentralen Web-Portals sowie Anwendungsentwicklung von Tools/Plugins zur Erleichterung der Arbeit des/der Sprachwissenschaftler und des Metadatenexperten. Schnittstellenentwicklung und Exportformate.
- 2 allgemeine Sprachwissenschaftler (1 x zuständig für Germanistik, 1 x zuständig für Romanistik) für die Klassifizierung und wechselseitige Verknüpfung der aus den Wörterbüchern extrahierten Entitäten.
- 1 FDM- und Metadatenexperten für die Anbindung der aus den Wörterbüchern extrahierten Entitäten an bestehende Normdatensysteme (v. a. GND, Wikidata, geonames) sowie für die dauerhafte Verfüg- und Auffindbarkeit der verwalteten strukturierten Daten (FAIR-compliance)
6. Stellenkalkulation
- 1) Informatik I (Algorithmusentwicklung für Tiefenstrukturierung) 0,65 TV-L E13
- 2) Informatik II (Anwendungsentwicklung Webportal und Tools) 0,65 TV-L E13
- 3) Vergleichende und indogermanische Sprachwissenschaft I (Germanistik) 0,65 TV-L E13
- 4) Vergleichende und indogermanische Sprachwissenschaft II (Romanistik) 0,65 TV-L E13
- 5) FDM (FAIR-compliance-Konzeption und Metadatenmanagement) 1,0 TV-L E13
Die Doppelbesetzung der Sprachwissenschaft ist neben der notwendigen Aufteilung nach Sprachfamilien durch den beträchtlichen Workload der zu erfassenden WB-Ressourcen begründet.
7. Antragsteller
- UB (federführend; FDM)
- CIS (Informatik I)
- ITG (Informatik II)
- Vergleichende und indogermanische Sprachwissenschaft (Sprachwissenschaft)
Bibliographie
- AWB = Frings, Theodor (1952-2015 ff.): Althochdeutsches Wörterbuch. Auf Grund der von Elias v. Steinmeyer hinterlassenen Sammlungen, Leipzig, Sächsische Akademie der Wissenschaften (Link).
- Boerio 1829 = Boerio, Giuseppe (1829): Dizionario del dialetto veneziano, Venezia (Link).
- Cherubini 1814 = Cherubini, Francesco (1814): Vocabolario milanese-italiano, 2 voll., Milano, Milano, Stamperia reale (Link).
- DOM = DOM en ligne: Dictionnaire de l'occitan médiéval (Link).
- DRG = Melcher, Florian / De Planta, Robert (Hrsgg.) (1939-): Dicziunari Rumantsch Grischun, Cuoira, Società Retorumantscha (Link).
- DWDS = Berlin-Brandenburgischen Akademie der Wissenschaften (Hrsg.): Digitales Wörterbuch der Deutschen Sprache. Das Wortauskunftssystem zur deutschen Sprache in Geschichte und Gegenwart, Berlin-Brandenburgischen Akademie der Wissenschaften (Link).
- FEW = atilf: Französisches etymologisches Wörterbuch (Link).
- Foti 2015 = Foti, Giuseppe (2015): Vocabolario del dialetto galloitalico di San Fratello, in: ArchivIA - Archivio istituzionale dell'Università di Catania, Tesi di dottorato, Area 10 - Scienze dell'antichità, filologico-letterarie e storico artistiche, Catania, Università di Catania (Link).
- Gemoll 1908 = Gemoll, Wilhelm (1908): Griechisches-deutsches Schul- und Handwörterbuch, Münchner Digitalisierungszentrum (Link).
- Georges = Georges, Karl Ernst (1913 [1998]): Ausführliches lateinisch-deutsches Handwörterbuch, Hannover (Darmstadt) (Link).
- Idiotikon = SchweizId. (1881-lfd.): Schweizerisches Idiotikon. Wörterbuch der schweizerdeutschen Sprache. Gesammelt auf Veranstaltung der Antiquarischen Gesellschaft in Zürich unter Beihülfe aus allen Kreisen des Schweizervolkes. Hg. mit Unterstützung des Bundes und der Kantone. Begonnen von Staub, Friedrich und Tobler, Ludwig. Fortges. unter der der Leitung von Bachmann, Albert, u.a., Frauenfeld (Link).
- Krefeld 2020 = Krefeld, Thomas (2020): Online-Lexikographie: ein Grundstein der Digital humanities, in: Lehre in den Digital Humanities, München, LMU (Link).
- Krefeld/Lücke 2020a = Krefeld, Thomas / Lücke, Stephan (2020): 54 Monate. VerbaAlpina – auf dem Weg zur FAIRness, in: Ladinia, vol. XLIII, 139-155.
- LEI = Pfister, Max / Schweickard, Wolfgang (1979-): Lessico etimologico italiano, Wiesbaden, Reichert.
- LEO = LEOs Wörterbücher (Link).
- LSJ = LSJ: The Online Liddell-Scott-Jones Greek-English Lexicon (Link).
- Pirona u. a. 1935 = Pirona, Giulio Andrea / Carletti, Ettore / Corgnali, Giovanni Battista (1935): Il Nuovo Pirona. Vocabolario friulano, Udine, Bosetti.
- Raccuglia 2003 = Raccuglia, Sandra (2003): Vocabolario del dialetto galloitalico di Aidone, Palermo, Centro di studi filologici e linguistici siciliani.
- REW = Meyer-Lübke, Wilhelm (1935): Romanisches etymologisches Wörterbuch 3., vollst. neubearb. Aufl., Heidelberg, Winter (Link).
- Schmeller = Schmeller, Johann Andreas (1872): Bayerisches Wörterbuch. 2 Bde. 2.
- Sottile 2002 = Sottile, Roberto (2002): Lessico dei pastori delle Madonie, Palermo, Centro di studi filologici e linguistici siciliani, Dipartimento di scienze filologiche e linguistiche, Università di Palermo (Link).
- Sottile/Genchi 2010 = Sottile, Roberto / Genchi, Massimo (2010): Lessico della cultura dialettale delle Madonie. 1. L'alimentazione, Palermo, Centro di studi filologici e linguistici siciliani.
- TLFi = atilf (1994): Trésor de la Langue Française informatisé, Nancy, Université de Lorraine - CNRS (Link).
- TLIO = Leonardi, Lino (2017): Tesoro della Lingua Italiana delle Origini Il primo dizionario storico dell'italiano antico che nasce direttamente in rete fondato da Pietro G. Beltrami. Data di prima pubblicazione: 15.10.1997 (Link).
- Trovato/Lanaia 2011 = Trovato, Salvator C. / Lanaia, Alfio (2011): Vocabolario-Atlante della cultura alimentare nella 'Sicilia lombarda', Palermo, Centro di studi filologici e linguistici siciliani.
- Verba Alpina = Krefeld, Thomas / Lücke, Stephan (2014-): VerbaAlpina. Der alpine Kulturraum im Spiegel seiner Mehrsprachigkeit, München (Link).
- VS = Giorgio, Piccitto (1985): Vocabolario siciliano, vol. II, Palermo, Centro di studi filologici e linguistici siciliani .